시작하기
기본 개념
중간 저장 없이 GCS의 파일을 Amazon S3로 바로 전송하기
Google Cloud Storage와 Amazon S3를 함께 사용하는 환경에서는 데이터가 생성되는 클라우드와 실제 데이터를 활용하거나 보관하는 클라우드가 서로 다를 수 있습니다.
예를 들어 GCP 환경에서 생성된 분석 데이터를 AWS의 데이터 처리 환경으로 전달하거나, GCS에 보관된 백업 파일을 Amazon S3의 별도 저장 영역으로 이동할 수 있습니다.
기존에는 다음과 같이 중간 환경을 거쳐 파일을 이동할 수 있습니다.
Google Cloud Storage
        │
        │ Download
        ▼
   Local PC / Server
        │
        │ Upload
        ▼
    Amazon S3
직접 전송을 구성하면 중간 저장 위치 없이 두 클라우드를 하나의 파일 흐름으로 연결할 수 있습니다.
┌─────────────────────┐
│ Google Cloud Storage│
│                     │
│   Source Bucket     │
└──────────┬──────────┘
           │
           │ Direct Transfer
           ▼
┌─────────────────────┐
│      Amazon S3      │
│                     │
│    Target Bucket    │
└─────────────────────┘
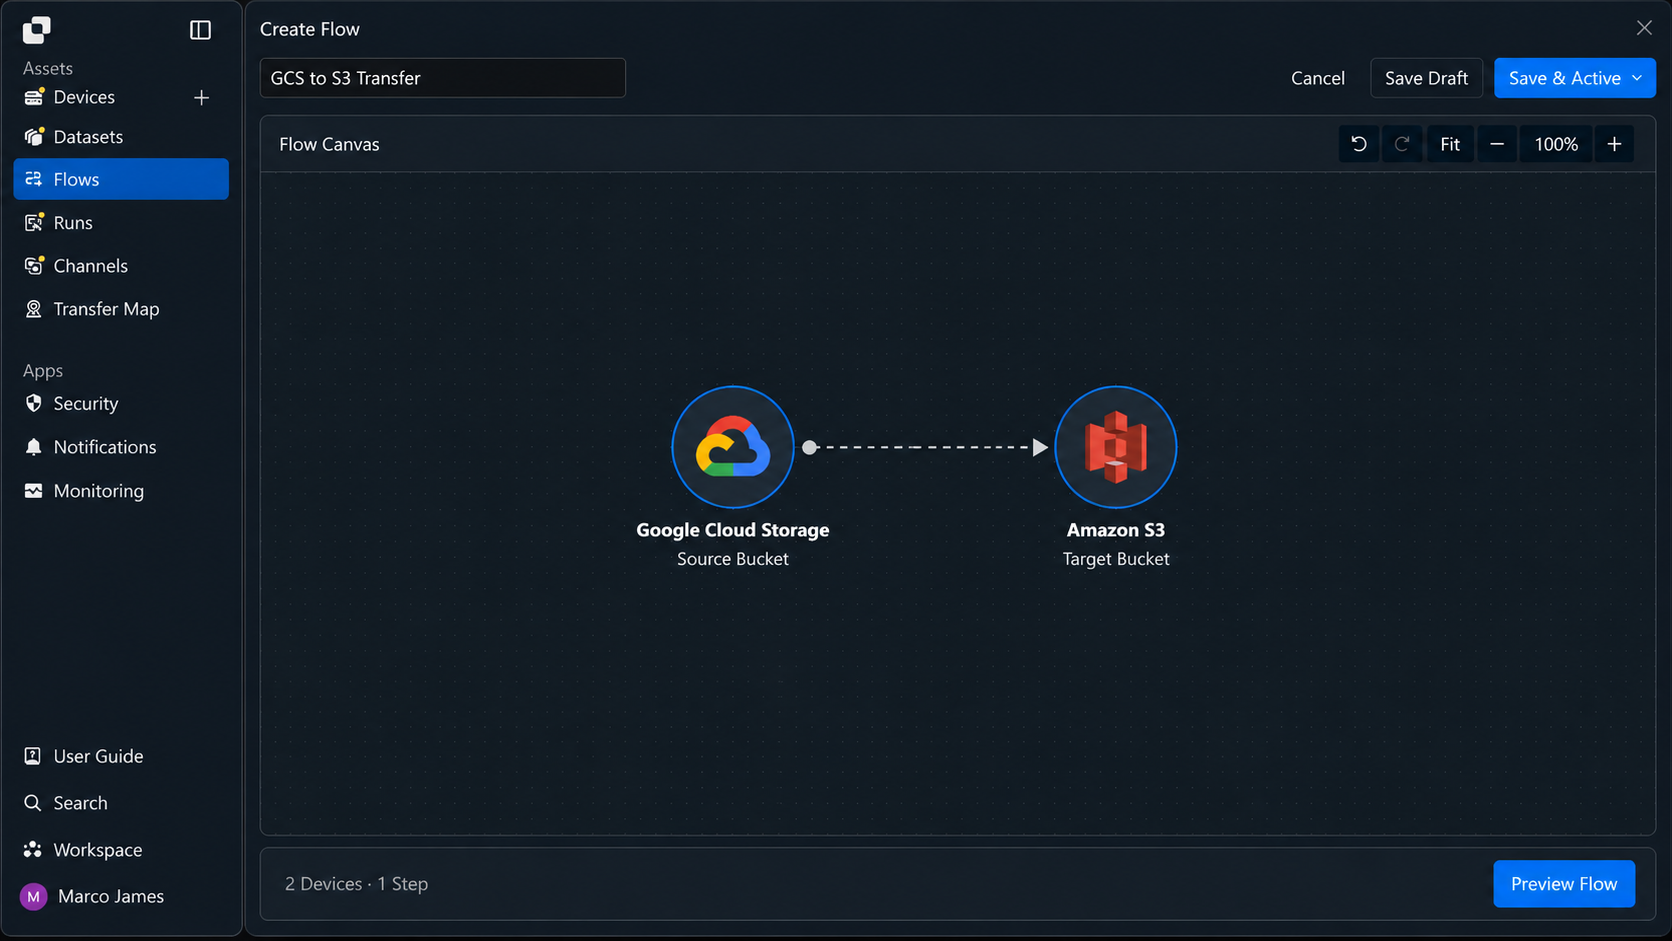
이렇게 하면 GCS에서 파일 선택 → Amazon S3로 직접 전송 → 대상 버킷 반영 확인까지 하나의 작업으로 이어갈 수 있습니다.
파일 범위
전체 Bucket이 아닌 필요한 파일과 경로만 전송하기
하나의 GCS Bucket에는 여러 서비스와 업무에서 사용하는 파일이 함께 저장될 수 있습니다.
따라서 모든 파일을 Amazon S3로 이동하기보다 실제 AWS 환경에서 필요한 데이터만 선택해 전송 범위를 구성할 수 있습니다.
예를 들어 GCS에 다음과 같은 파일 구조가 있다고 가정합니다.
gcs-data-bucket
│
├── export/
│   ├── daily/
│   │   ├── report-01.csv
│   │   └── report-02.csv
│   │
│   └── monthly/
│
├── logs/
│
├── backup/
│
└── temporary/
이 중 export/daily/에 생성되는 파일만 Amazon S3로 전송할 수 있습니다.
Google Cloud Storage                    Amazon S3

gcs-data-bucket                         aws-data-bucket
│                                       │
├── export/                             └── incoming/
│   └── daily/          ───────────▶        └── daily/
│       Selected                                 │
│                                                ├── report-01.csv
├── logs/        Not Included                   └── report-02.csv
├── backup/      Not Included
└── temporary/   Not Included
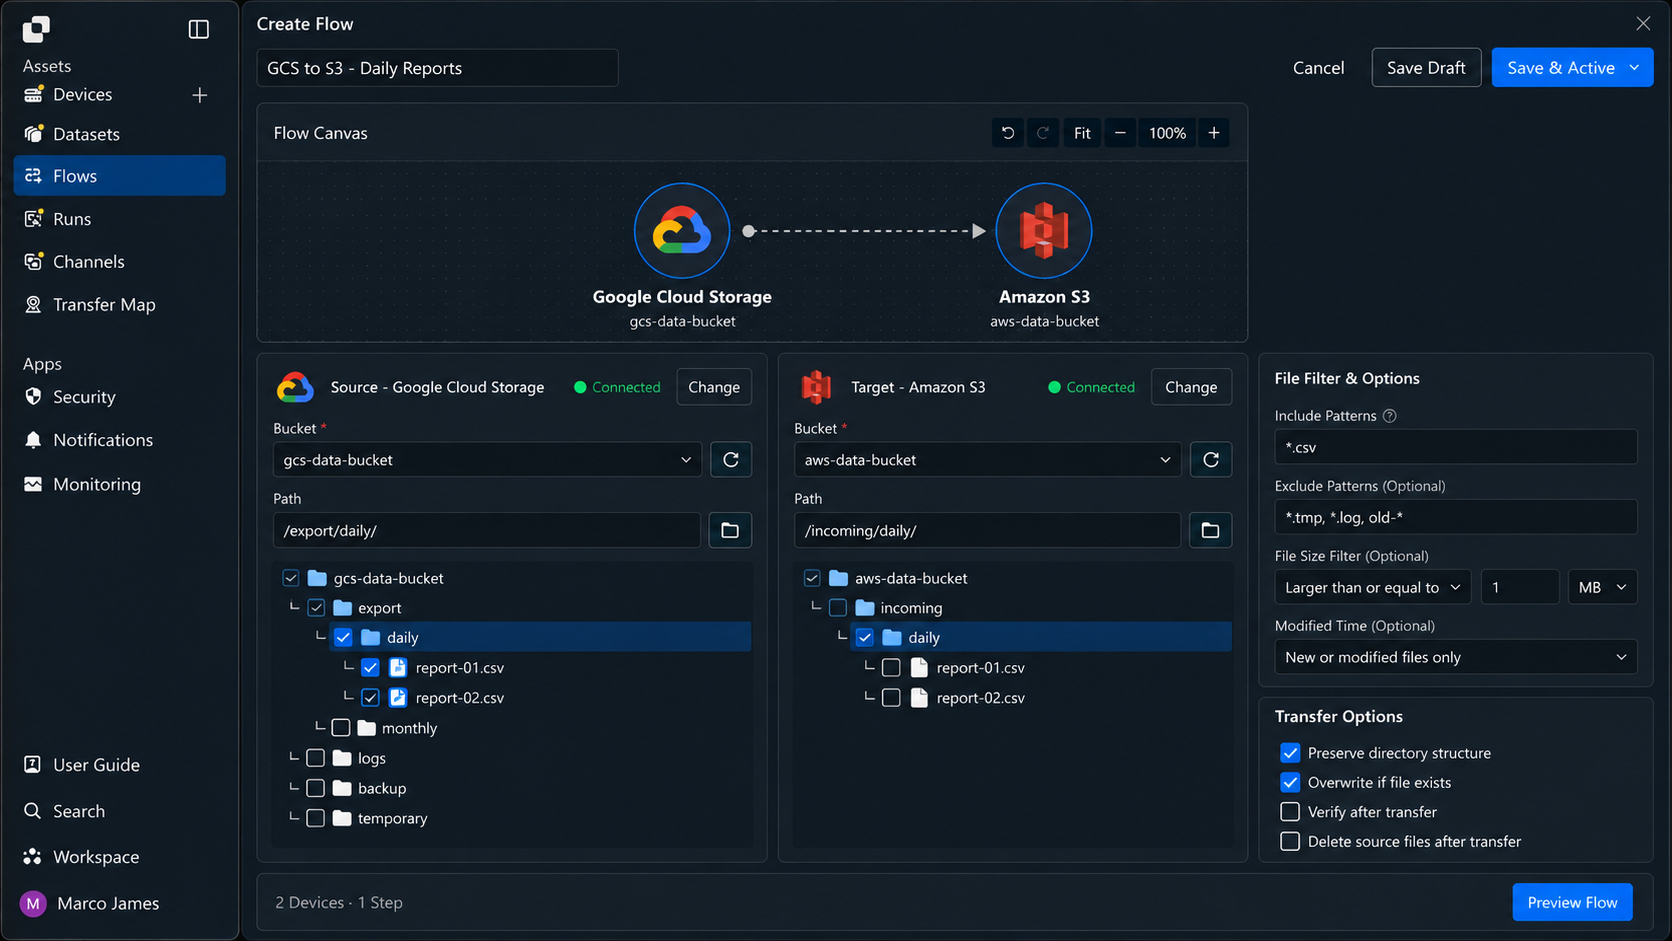
전송 범위는 파일 구조와 업무 목적에 따라 구분할 수 있습니다.
| 설정 기준 | 활용 |
|---|---|
| Source 경로 | GCS에서 전송할 파일이 있는 경로 지정 |
| Target 경로 | S3에서 파일을 저장할 Bucket과 Prefix 지정 |
| 파일 이름 | 특정 이름 규칙에 맞는 파일만 선택 |
| 확장자 | CSV, JSON, ZIP 등 필요한 유형만 전송 |
| 제외 조건 | 임시 파일이나 특정 경로 제외 |
| 변경 여부 | 새로 생성되거나 변경된 파일만 처리 |
이를 통해 클라우드 전체의 데이터를 반복적으로 이동하는 대신 AWS 환경에서 실제로 필요한 파일만 선택적으로 전송할 수 있습니다.
활용 방식
한 번에 이전하거나 새 파일과 변경 파일을 기준으로 이어서 전송하기
GCS에서 S3로 파일을 이동하는 방식은 단순한 일회성 전송에만 사용할 필요가 없습니다.
기존 데이터를 먼저 이동한 뒤, 이후에는 새로 생성되거나 변경된 파일만 S3에 반영하도록 구성할 수 있습니다.
예를 들어 파일의 생성 방식과 AWS 환경에서 데이터를 사용하는 시점에 따라 전송 방식을 선택할 수 있습니다.
| 전송 목적 | 구성 방식 |
|---|---|
| 기존 데이터 이전 | 지정된 경로의 파일을 한 번에 전송 |
| 정기 데이터 전달 | 지정된 날짜와 시간에 반복 실행 |
| 신규 파일 반영 | 새 파일 생성에 맞춰 전송 |
| 변경 파일 동기화 | 변경된 파일만 확인해 반영 |
| 다음 작업 연결 | 이전 작업이 완료된 후 후속 전송 실행 |
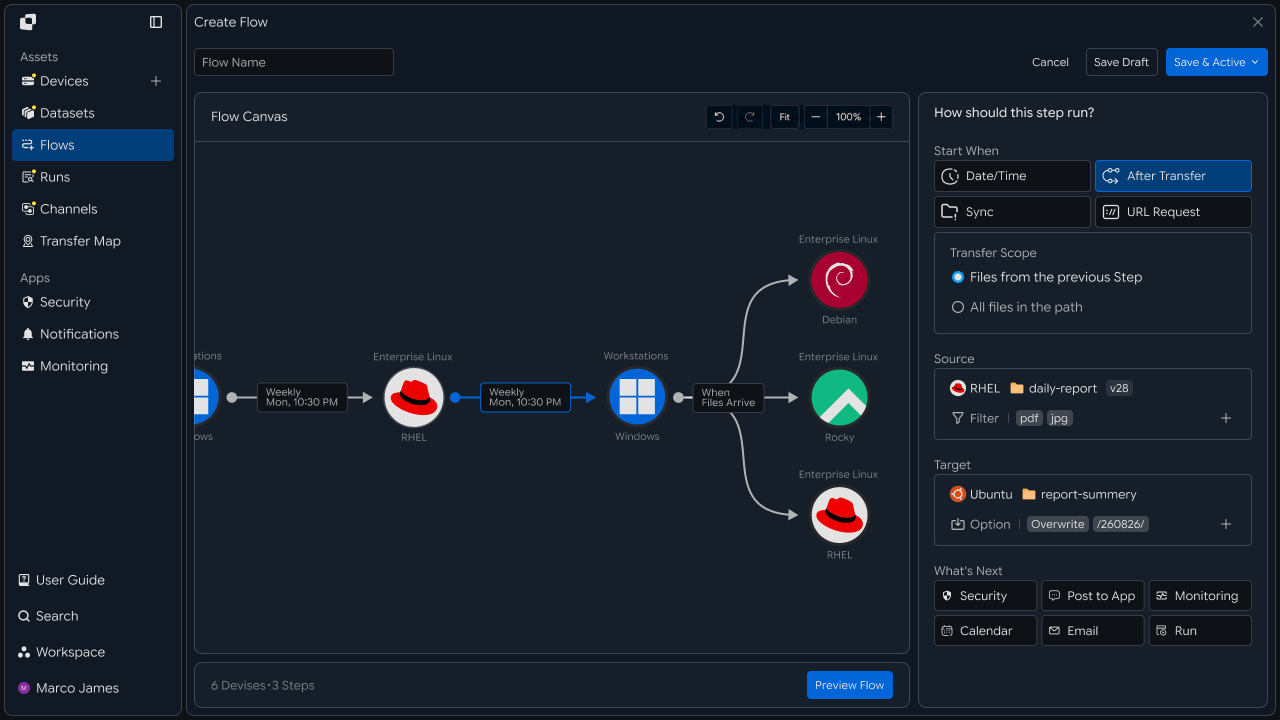
예를 들어 GCS에 하루 동안 생성된 데이터를 AWS 분석 환경에서 매일 활용한다면, 정해진 시간에 해당 경로를 확인하고 새로운 파일만 S3로 전송하도록 구성할 수 있습니다.
반대로 기존 데이터를 먼저 대량으로 이동한 뒤, 이후 변경되는 파일만 지속적으로 반영하는 방식으로도 활용할 수 있습니다.
IT 엔지니어
환경 연결
Google Cloud Storage와 Amazon S3를 각각 전송 환경에 연결하기
먼저 파일을 가져올 Google Cloud Storage와 파일을 저장할 Amazon S3를 각각 연결합니다.
두 클라우드는 서로 다른 환경이므로 Source와 Target에서 필요한 접근 범위를 독립적으로 관리합니다.
GCS에서는 지정된 Bucket과 파일 경로를 읽을 수 있어야 하며, Amazon S3에서는 대상 Bucket과 경로에 파일을 저장할 수 있어야 합니다.
Cloud Connections

Google Cloud Storage
└── Source Bucket
    └── Read Files

Amazon S3
└── Target Bucket
    └── Write Files
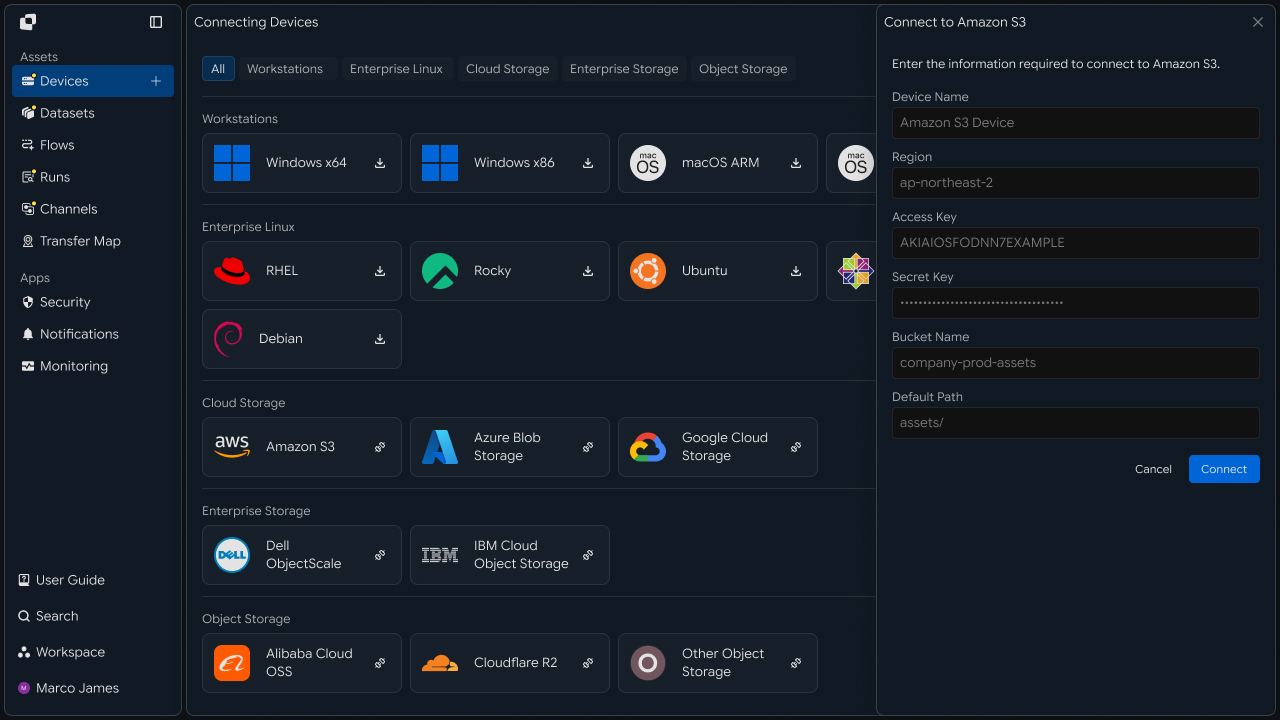
전송 작업을 구성하기 전에 다음 항목을 확인합니다.
| 구분 | 확인 내용 |
|---|---|
| GCS 연결 | Source Bucket 접근 가능 여부 |
| Source 범위 | 전송할 파일과 경로 읽기 가능 여부 |
| S3 연결 | Target AWS 환경 연결 상태 |
| Target 범위 | 지정된 Bucket과 Prefix 확인 |
| 저장 권한 | S3에 파일을 생성하고 저장할 수 있는지 확인 |
| 파일 경로 | Source와 Target의 전송 경로 확인 |
각 클라우드 환경을 개별적으로 연결하면 접근 범위를 분리하면서도 하나의 Flow에서 두 Storage를 직접 연결할 수 있습니다.
경로 매핑
GCS의 파일 구조를 S3의 저장 구조에 맞춰 연결하기
Storage 연결이 완료되면 Source에서 파일을 가져올 경로와 Target에서 파일을 저장할 위치를 지정합니다.
예를 들어 GCS의 다음 경로를 Source로 선택할 수 있습니다.
gs://gcs-data-bucket/export/daily/
Amazon S3에서는 다음 위치를 Target으로 지정합니다.
s3://aws-data-bucket/incoming/gcp/
두 경로를 연결하면 파일은 다음과 같이 이동합니다.
Source

Google Cloud Storage
gcs-data-bucket
└── export/
    └── daily/
        ├── report-01.csv
        ├── report-02.csv
        └── report-03.csv

                 │
                 │ Transfer
                 ▼

Target

Amazon S3
aws-data-bucket
└── incoming/
    └── gcp/
        ├── report-01.csv
        ├── report-02.csv
        └── report-03.csv
업무에 따라 Source의 폴더 구조를 그대로 유지하거나, AWS 환경에서 사용하는 데이터 구조에 맞게 다른 Prefix 아래에 파일을 저장할 수도 있습니다.
예를 들어 GCS의 여러 경로를 하나의 S3 Bucket으로 모으되, 데이터 유형별로 서로 다른 Prefix에 저장하도록 구성할 수 있습니다.
Flow 구성
서로 다른 클라우드의 Storage를 하나의 전송 작업으로 연결하기
Source와 Target 경로를 설정한 뒤 Flow에서 Google Cloud Storage와 Amazon S3를 직접 연결합니다.
Source에서는 GCS에 저장된 파일을 확인하고, 설정된 조건에 따라 전송 대상을 선택합니다. 이후 Target에서는 지정된 S3 Bucket과 Prefix에 파일을 반영합니다.
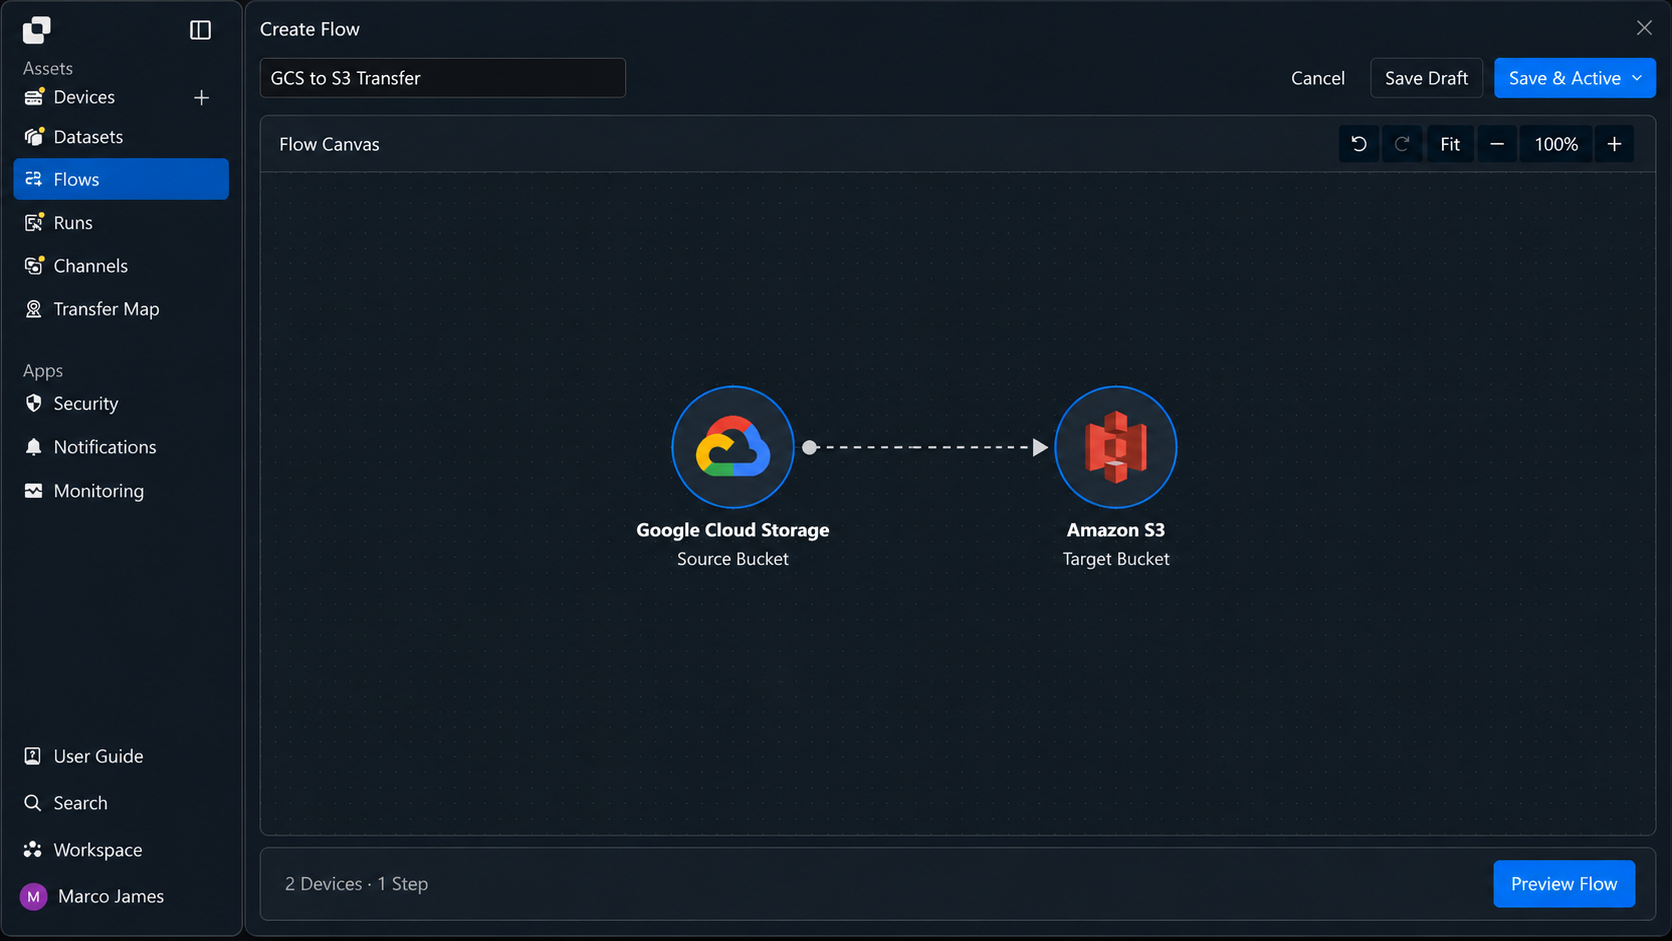
기본적인 전송 구조는 다음과 같습니다.
Google Cloud Storage
        │
        │ Files
        ▼
┌─────────────────┐
│  Transfer Flow  │
│                 │
│ Path / Filter   │
│ Run Condition   │
└────────┬────────┘
         │
         ▼
     Amazon S3
        │
        ▼
   Target Prefix
필요한 경우 하나의 Source를 여러 S3 저장 위치로 분기하거나, 여러 GCS Bucket의 파일을 하나의 S3 환경으로 수집하는 방식으로 확장할 수도 있습니다.
예를 들어 데이터 유형에 따라 Target을 분리하면 다음과 같은 구성이 가능합니다.
                     ┌──▶ S3 / analytics/
                     │
GCS Source ── Flow ──┼──▶ S3 / archive/
                     │
                     └──▶ S3 / processing/
이처럼 단순한 클라우드 간 파일 전송을 시작점으로 두고, 파일의 종류와 이후 활용 환경에 따라 여러 AWS 저장 경로로 확장할 수 있습니다.
전송 연결
S3에 파일이 반영된 이후의 작업까지 자동으로 이어가기
GCS에서 파일을 Amazon S3로 전송한 후에는 S3에 파일이 정상적으로 반영된 결과를 기준으로 다음 작업을 연결할 수 있습니다.
예를 들어 S3에 데이터 파일이 저장되면 다음 데이터 처리 작업을 실행하거나, 다른 시스템으로 파일을 다시 전송하도록 구성할 수 있습니다.
GCS Files
    │
    ▼
Amazon S3 Transfer
    │
    ├──────────────▶ Data Processing
    │
    ├──────────────▶ Next Flow
    │
    └──────────────▶ Completion Notice
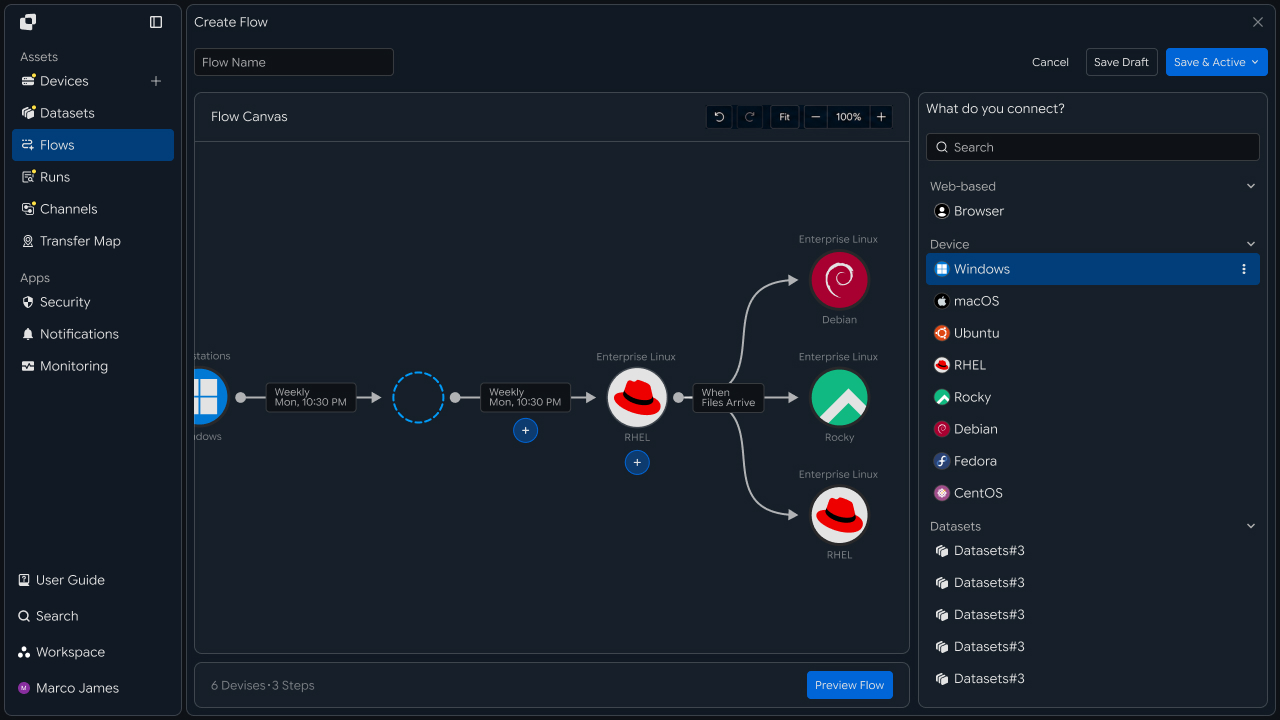
후속 작업은 전송 결과를 기준으로 연결할 수 있으므로 파일이 정상적으로 처리된 이후에만 다음 단계를 실행하도록 구성할 수 있습니다.
| 연결 영역 | 활용 방식 |
|---|---|
| 데이터 처리 | S3에 저장된 파일을 분석·처리 환경에서 활용 |
| 다음 Flow | 다른 Storage나 시스템으로 파일 전송 |
| 업무 알림 | 전송 완료와 실패 결과 전달 |
| 운영 환경 | 실행 상태와 처리 결과 확인 |
이를 통해 단순히 GCS의 파일을 S3로 이동하는 것에서 끝나는 것이 아니라 클라우드 간 전송 → 파일 반영 → 다음 처리 작업까지 이어지는 파일 워크플로를 구성할 수 있습니다.
결과 검증
전송된 파일과 Amazon S3의 반영 결과 함께 확인하기
전송 작업이 실행되면 Runs에서 전체 진행 상태와 전송 결과를 확인할 수 있습니다.
특정 Run을 선택하면 Source와 Target, 전체 파일 수와 전송량을 확인하고 필요한 경우 파일별 처리 결과까지 확인할 수 있습니다.
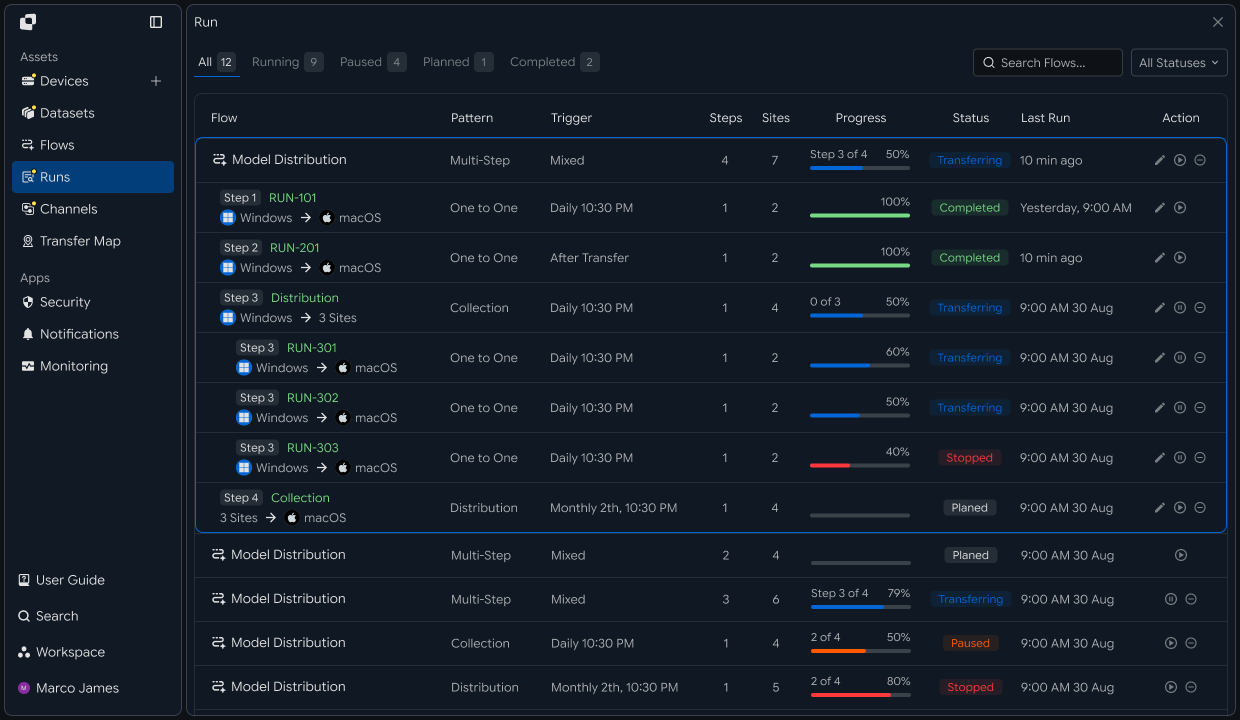
전송 결과에서는 다음 정보를 함께 확인할 수 있습니다.
| 확인 항목 | 확인 내용 |
|---|---|
| Source | Google Cloud Storage Bucket과 원본 경로 |
| Target | Amazon S3 Bucket과 대상 Prefix |
| Total Files | 전체 전송 파일 수 |
| Total Size | 전체 전송 용량 |
| Progress | 현재 또는 최종 전송 진행률 |
| Status | 실행 완료·진행·실패 상태 |
| Started | 전송 시작 시간 |
| Completed | 전송 완료 시간 |
예를 들어 Run이 완료된 후에는 전체 작업 상태뿐 아니라 실제로 S3의 지정된 경로에 필요한 파일이 정상적으로 반영되었는지 함께 확인할 수 있습니다.
이를 통해 GCS에서 몇 개의 파일을 가져왔는지와 S3에 어떤 결과로 저장되었는지 하나의 실행 기록을 기준으로 확인할 수 있습니다.
문제 처리
Source와 Target을 구분해 확인하고 필요한 작업만 다시 실행하기
클라우드 간 전송 중 문제가 발생하면 먼저 GCS와 Amazon S3 중 어느 환경에서 추가 확인이 필요한지 구분합니다.
Source 파일을 읽을 수 없는 경우에는 GCS 연결 상태와 파일 경로, 접근 범위를 확인합니다. 반대로 Target에 파일을 저장할 수 없는 경우에는 S3 Bucket과 Prefix, 저장 권한을 확인합니다.
| 확인 위치 | 주요 확인 항목 | 조치 방향 |
|---|---|---|
| GCS Source | Bucket 연결 상태 | 연결 환경 확인 |
| Source 경로 | 파일 위치와 선택 조건 | 경로 또는 필터 조정 |
| Source 권한 | 파일 읽기 가능 여부 | 접근 범위 확인 |
| S3 Target | Bucket과 Prefix | 대상 경로 확인 |
| Target 권한 | 파일 저장 가능 여부 | 쓰기 권한 확인 |
| Run | 실패 파일과 처리 기록 | 필요한 작업 Retry |
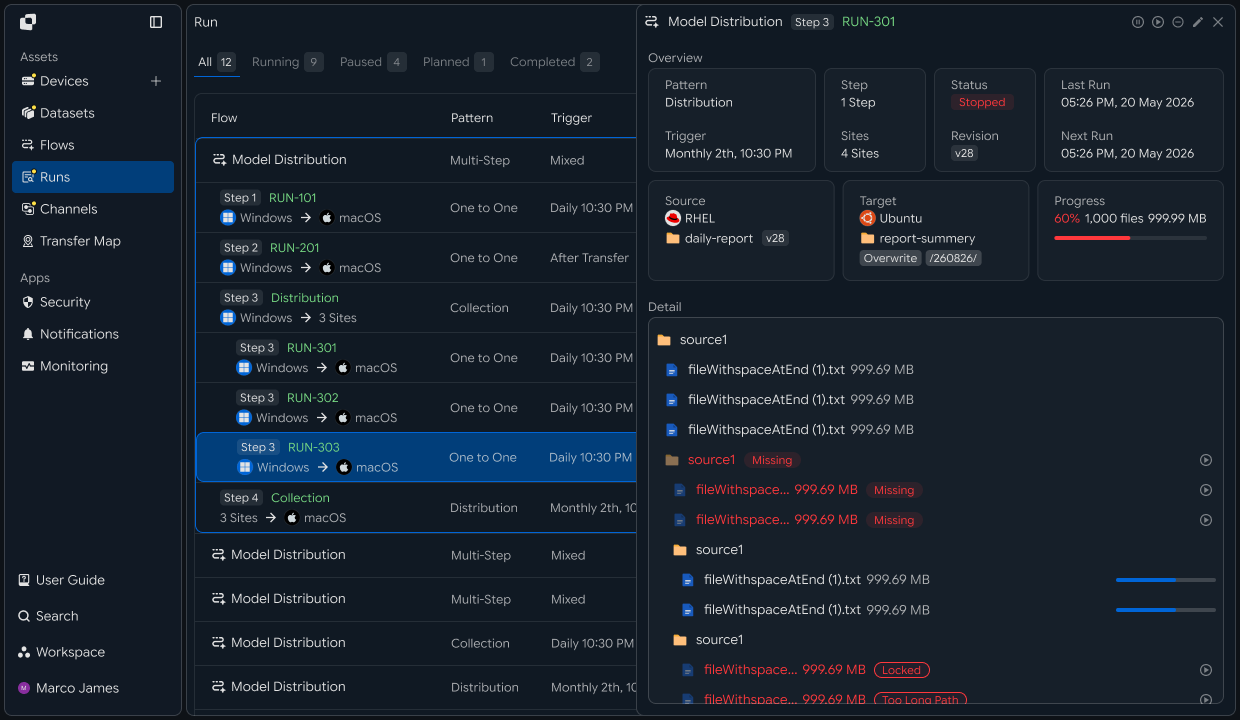
문제를 확인하고 필요한 환경을 조정한 뒤에는 전체 전송을 처음부터 다시 구성하는 대신 해당 작업을 다시 실행해 결과를 확인할 수 있습니다.
이 레시피를 적용하면 Google Cloud Storage 연결 → Source 파일과 경로 선택 → Amazon S3 Target 구성 → 파일 조건과 실행 기준 설정 → 클라우드 간 직접 전송 → S3 반영 후 다음 작업 연결 → Run 결과 확인 → 대상 파일 검증까지 하나의 흐름으로 구성할 수 있습니다.
이를 통해 로컬 PC나 중간 저장 서버를 거치지 않고, GCS에서 생성되거나 저장된 파일을 Amazon S3의 지정된 Bucket과 경로로 직접 이동하고 이후 처리와 운영 확인까지 연결하는 클라우드 간 파일 전송 환경을 구성할 수 있습니다.
개발자
GCS 객체를 S3로 전송하고 결과를 확인하기
소스·대상 스토리지를 각각 장비로 등록한 뒤, 프리픽스를 지정해 전송을 만들고 종료 상태를 확인합니다. 시작 전에 다음 항목을 준비합니다.
| 준비물 | 내용 |
|---|---|
| INNORIX 인증 | INNORIX_ACCESS_TOKEN (Authorization: Bearer) |
| 소스 GCS 장비 | GCS 버킷의 device ID와 원본 프리픽스 (예: logs/2026/09) |
| 대상 S3 장비 | S3 버킷의 device ID와 대상 프리픽스 (예: imported/2026/09) |
| 런타임 | Python 3 + requests · Java 17+ · Node.js 18+ · .NET 8+ |
Python·Node.js는 REST를 직접 호출하는 최소
api()헬퍼와 상태 상수(STATUS_COMPLETE·TERMINAL)를 API 호출 레시피의 것을 재사용합니다. Java·C#은 번들 소스의InnorixClient(상수 포함)와Json(C#은J) 헬퍼를 사용합니다. 장비 식별자(gcs-src·s3-dst)와 프리픽스는 실제 값으로 바꿔 넣습니다.
GCS → S3 전송 생성
프리픽스를 폴더 루트로 넣어(sourcePaths + sendAllFolder) 전송을 만듭니다. target-action은 overwrite로 지정해 대상 프리픽스에 동일한 객체가 있을 때 덮어쓰도록 합니다. 전송 생성 후 monitorId로 종료 상태를 확인합니다.
import time


def transfer_objects(source, target, prefixes, target_prefix, action="overwrite"):
    transfer = api("POST", "/api/transfers/manual", {
        "sourceDevice": source,
        "targetDevice": target,
        "targetPath": target_prefix,
        "sourcePaths": prefixes,
        "sendAllFolder": True,
        "transferOptions": {"target-action": action},
    })
    return transfer["monitorId"]


def wait_transfer(monitor_id, timeout=14400, interval=5):
    deadline = time.time() + timeout
    while time.time() < deadline:
        detail = api("GET", f"/api/transfers/{monitor_id}") or {}
        if detail.get("status") in TERMINAL:
            return detail
        time.sleep(interval)
    raise TimeoutError(monitor_id)


monitor_id = transfer_objects("gcs-src", "s3-dst", ["logs/2026/09"], "imported/2026/09")
detail = wait_transfer(monitor_id)
print("completed:", detail.get("status") == STATUS_COMPLETE)
덮어쓰기 동작
numbering을 사용하면 대상에 같은 이름의 객체가 있을 때 이름이 변경될 수 있습니다. 대상 객체를 원본 이름 그대로 갱신하려면overwrite를 사용합니다.
대량 객체 분할 객체가 많은 버킷은 하나의 전송으로 처리하면 원본 열거에 시간이 오래 걸릴 수 있습니다. 프리픽스 단위로 여러 전송으로 나누면 각 전송의 범위가 명확해지고 실패 지점을 좁게 파악할 수 있습니다.
실패 객체가 남으면 중단 후 재개 레시피의 retry_failed(GET /api/transfers/{id}/files → POST /api/transfers/{id}/retry)로 실패분만 다시 전송합니다.
구현 결과
이 레시피를 적용하면 다음 흐름으로 GCS의 객체를 S3로 전달할 수 있습니다.
Google Cloud Storage (gcs-src) — 프리픽스 지정
   ↓

전송 생성 (overwrite) → 종료 상태까지 대기
   ↓

Amazon S3 (s3-dst) — 대상 프리픽스에 객체 반영
   ↓

실패 객체만 재시도
클라우드 자격 증명을 코드에서 다루지 않고 device ID만으로 GCS → S3 전송을 실행하며, 남은 실패 객체만 선택해 다시 보낼 수 있습니다.