시작하기
기본 개념
컨테이너 작업 결과를 외부 저장 환경으로 직접 전달하기
Kubernetes에서 실행되는 애플리케이션이나 배치 작업은 다양한 파일을 생성할 수 있습니다.
예를 들어 데이터 처리 Job이 결과 파일을 생성하거나, 미디어 변환 워크로드가 처리된 영상을 저장하고, 분석 작업이 CSV 또는 JSON 파일을 생성할 수 있습니다.
기존에는 작업 결과를 별도의 관리 과정으로 외부에 옮길 수 있습니다.
Kubernetes Cluster
        │
        ▼
   Pod / Container
        │
        │ Result File
        ▼
   Temporary Storage
        │
        │ Manual / Script
        ▼
External Storage
전송 Flow를 구성하면 Kubernetes에서 생성된 파일과 외부 저장 환경을 직접 연결할 수 있습니다.
┌────────────────────────┐
│   Kubernetes Cluster   │
│                        │
│   Pod / Workload       │
│        │               │
│        ▼               │
│   Result Files         │
└────────────┬───────────┘
             │
             │ File Transfer
             ▼
┌────────────────────────┐
│    External Storage    │
│                        │
│   S3 / File Server     │
└────────────────────────┘
이렇게 하면 워크로드 실행 → 결과 파일 생성 → 외부 스토리지 전송 → 저장 결과 확인까지 하나의 파일 흐름으로 연결할 수 있습니다.
파일 위치
워크로드별 결과 파일 경로를 선택해 필요한 데이터만 전달하기
하나의 Kubernetes 환경에서는 여러 애플리케이션과 작업이 동시에 실행될 수 있습니다.
따라서 모든 파일을 외부로 전송하기보다, 실제 보관하거나 다음 업무에서 사용할 결과 파일의 생성 위치를 기준으로 전송 범위를 구성할 수 있습니다.
예를 들어 처리 작업에서 다음과 같은 파일 구조가 생성된다고 가정합니다.
/data/job/
│
├── input/
│   └── source-data.csv
│
├── processing/
│   └── temporary.json
│
├── output/
│   ├── result-01.csv
│   ├── result-02.csv
│   └── summary.json
│
└── logs/
    └── job.log
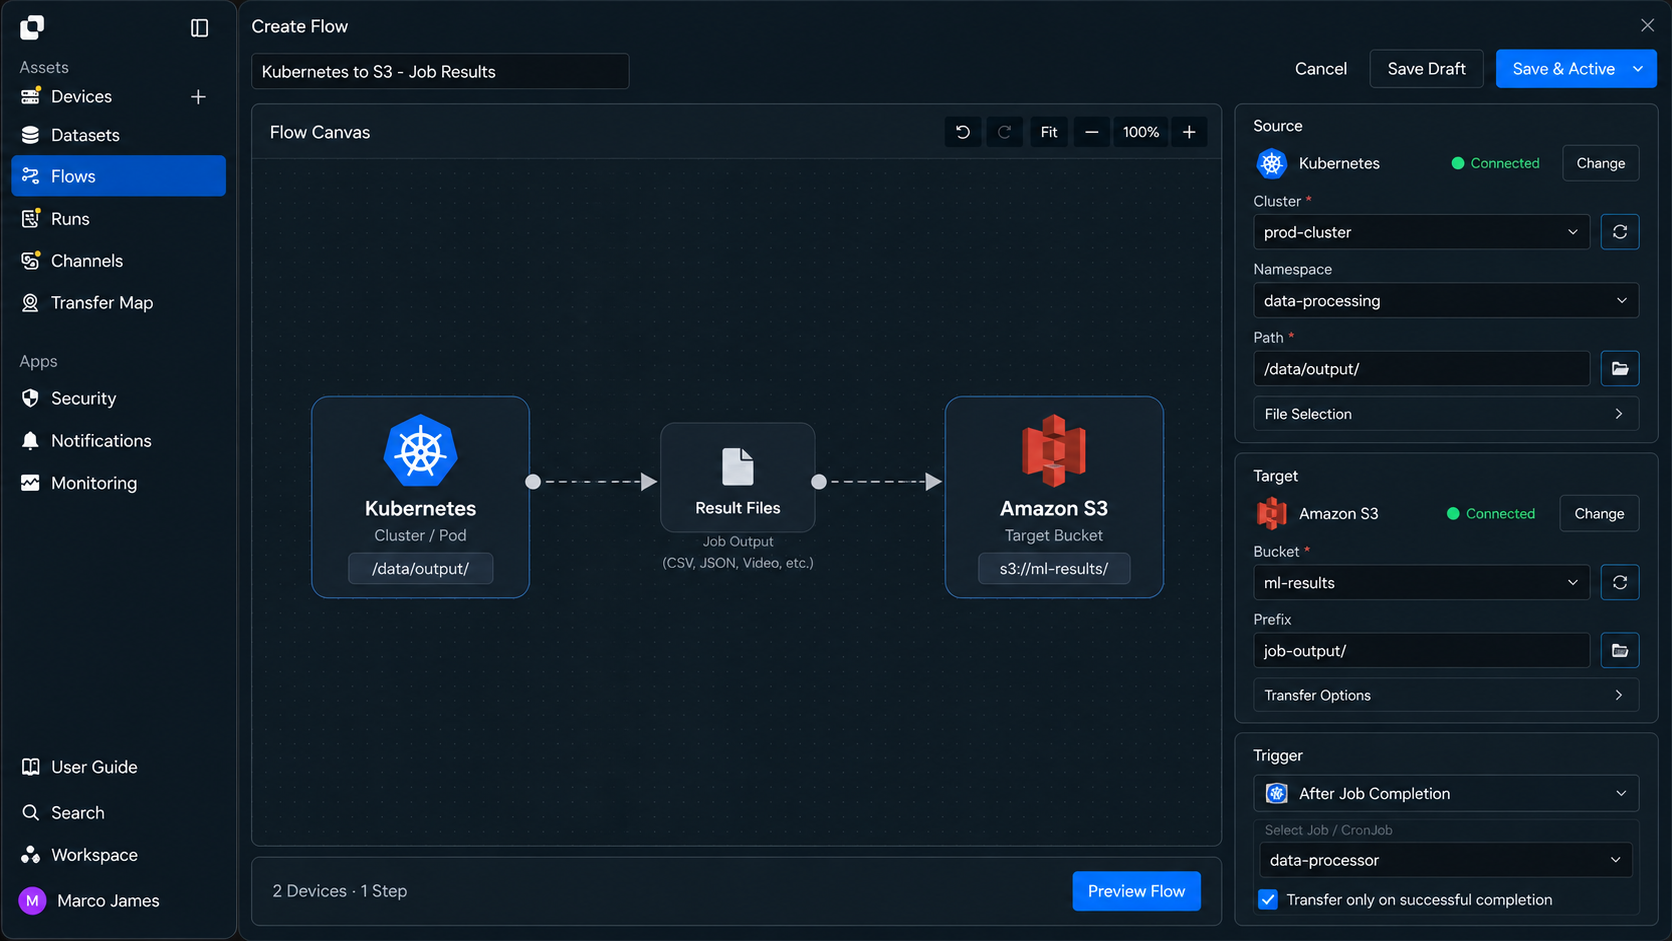
이 경우 실제 처리 결과가 저장되는 output/ 경로만 외부 스토리지로 전달할 수 있습니다.
Kubernetes Workload                   External Storage

/data/job/                            result-storage
│                                     │
├── input/          Not Included      │
├── processing/     Not Included      │
│                                     │
└── output/         ─────────────▶    └── daily/
    ├── result-01.csv                      ├── result-01.csv
    ├── result-02.csv                      ├── result-02.csv
    └── summary.json                       └── summary.json
[제품UI_Kubernetes Source의 파일 경로를 지정하고 결과 파일이 저장될 외부 스토리지의 Target 경로를 설정하는 화면]
전송 범위를 명확하게 구성하면 처리 과정에서 생성되는 임시 파일까지 모두 이동하는 대신 최종 결과 파일을 중심으로 외부 저장과 후속 활용 환경을 구성할 수 있습니다.
전송 시점
작업 완료 후 결과 파일이 준비되는 시점에 맞춰 전송하기
컨테이너 환경에서는 파일이 생성되기 전에 전송 작업이 시작되지 않도록 워크로드의 실행 상태와 파일 생성 시점을 함께 고려할 수 있습니다.
예를 들어 배치 작업이 완료된 후 결과 파일을 전송하거나, 지정된 경로에 새로운 파일이 생성되면 자동으로 외부 스토리지에 반영하도록 구성할 수 있습니다.
| 실행 기준 | 활용 방식 |
|---|---|
| 작업 완료 후 | 워크로드가 결과 파일을 생성한 뒤 전송 |
| 새 파일 감지 | 지정 경로에 새 파일이 생성되면 자동 전송 |
| 정기 실행 | 일정에 따라 결과 파일을 수집 |
| 이전 작업 완료 | 앞 단계 Flow가 완료된 후 다음 전송 시작 |
| 변경 파일 확인 | 수정되거나 새로 생성된 파일만 반영 |
예를 들어 데이터 처리 작업이 완료된 이후 다음 Flow를 실행하도록 구성할 수 있습니다.
Data Processing Job
        │
        ▼
Result File Created
        │
        ▼
Transfer Condition
        │
        ▼
External Storage
        │
        ▼
Result Verification
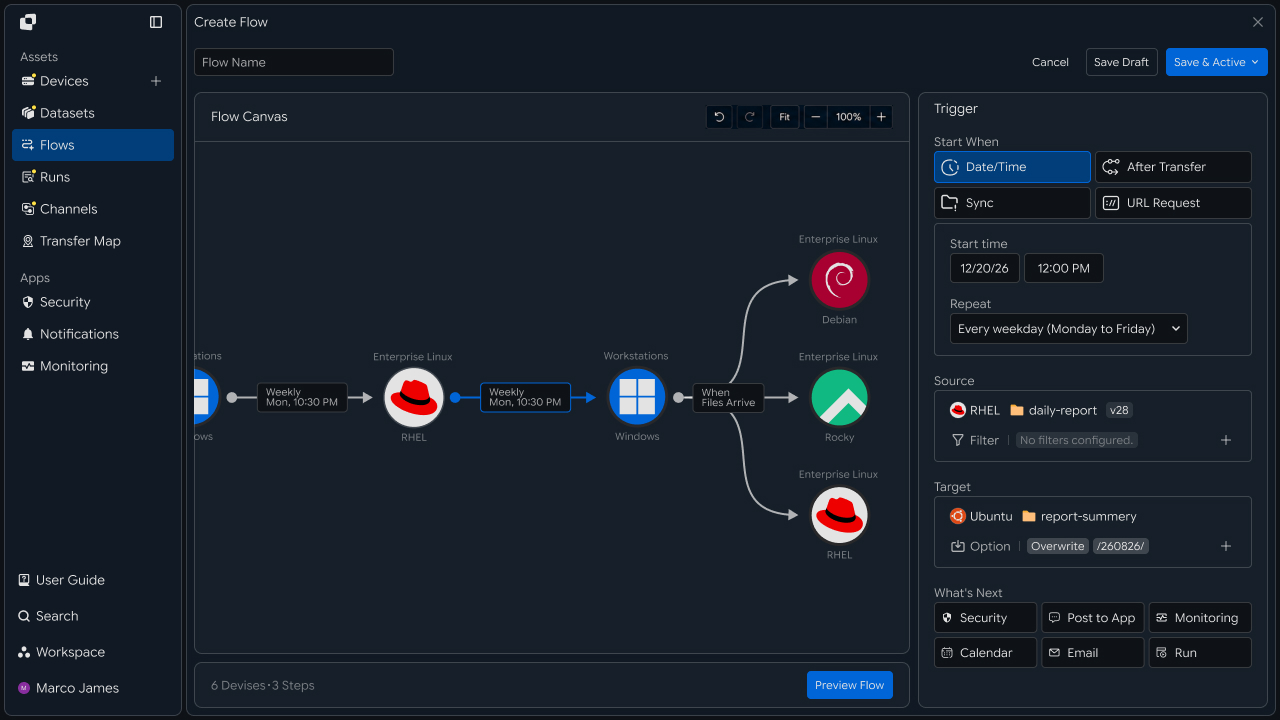
이렇게 하면 작업이 진행 중인 파일을 미리 이동하는 대신 결과 파일이 준비된 시점을 기준으로 외부 저장 작업을 연결할 수 있습니다.
IT 엔지니어
환경 연결
Kubernetes 파일 생성 환경과 외부 저장소를 전송 경로로 연결하기
먼저 결과 파일이 생성되는 Kubernetes 환경과 파일을 저장할 외부 스토리지를 각각 연결합니다.
Source에서는 워크로드가 생성한 파일을 확인하고 읽을 수 있어야 하며, Target에서는 전달된 파일을 지정된 위치에 저장할 수 있어야 합니다.
Transfer Environment

Kubernetes
└── Workload
    └── Result Path
        └── Read Files

            │
            ▼

        Transfer Flow

            │
            ▼

External Storage
├── Amazon S3
├── File Server
└── Storage Path
    └── Write Files
전송 작업을 구성하기 전에 다음 항목을 함께 확인합니다.
| 연결 환경 | 확인 내용 |
|---|---|
| Kubernetes | 파일 생성 환경과 연결 상태 |
| Source 경로 | 결과 파일이 생성되는 위치 |
| 워크로드 | 파일 생성 작업과 실행 상태 |
| 외부 스토리지 | Target 연결 상태 |
| 저장 경로 | 결과 파일이 저장될 위치 |
| 접근 범위 | Source 읽기와 Target 저장 권한 |
각 환경을 분리해 연결하면 Kubernetes의 파일 생성 위치와 외부 스토리지의 저장 위치를 하나의 Flow로 연결하면서도 각각의 접근 범위를 관리할 수 있습니다.
대상 구성
S3 보관과 파일 서버 전달을 업무 목적에 맞게 나누기
Kubernetes에서 생성된 결과 파일은 활용 목적에 따라 서로 다른 외부 환경으로 전달할 수 있습니다.
장기 보관이나 여러 서비스에서 활용할 파일은 Amazon S3로 전송하고, 사내 프로그램에서 바로 사용해야 하는 파일은 내부 파일 서버로 전달하는 방식으로 구성할 수 있습니다.
                     ┌─────────────────┐
                     │   Amazon S3     │
                     │ Backup / Archive│
                     └────────▲────────┘
                              │
                              │
Kubernetes Result Files ──────┤
                              │
                              │
                     ┌────────┴────────┐
                     │  File Server    │
                     │ Processing Path │
                     └─────────────────┘
대상별 활용 방식은 다음과 같이 나눌 수 있습니다.
| Target | 활용 방식 |
|---|---|
| Amazon S3 | 처리 결과와 대용량 파일 보관 |
| 외부 파일 서버 | 내부 프로그램의 후속 처리 |
| 분석 서버 | 분석 시스템에서 결과 파일 활용 |
| 백업 스토리지 | 장기 보관과 복구용 파일 저장 |
이처럼 하나의 결과 파일을 여러 환경으로 전달하거나, 파일 유형에 따라 서로 다른 Target으로 분기해 저장할 수 있습니다.
파일 선별
결과 파일과 임시 파일을 구분해 전송 범위 설정하기
컨테이너 작업 중에는 최종 결과 외에도 임시 파일, 중간 처리 파일, 로그 등이 함께 생성될 수 있습니다.
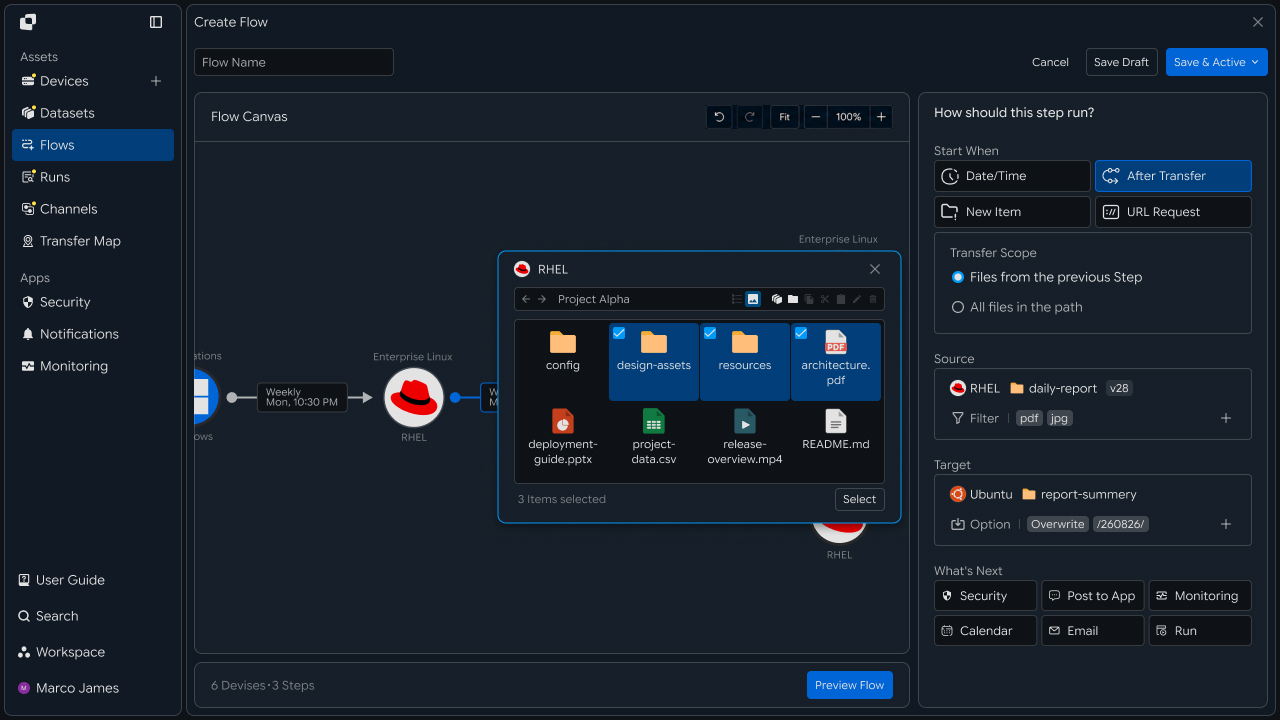
따라서 파일 경로나 이름, 확장자를 기준으로 실제 외부에 전달할 파일만 선택할 수 있습니다.
예를 들어 다음과 같이 구성할 수 있습니다.
| 파일 조건 | 처리 방식 |
|---|---|
output/*.csv | S3로 전송 |
output/*.json | 분석 서버로 전달 |
archive/*.zip | 장기 보관 스토리지로 전송 |
tmp/* | 전송 대상 제외 |
logs/* | 별도 로그 수집 Flow로 연결 |
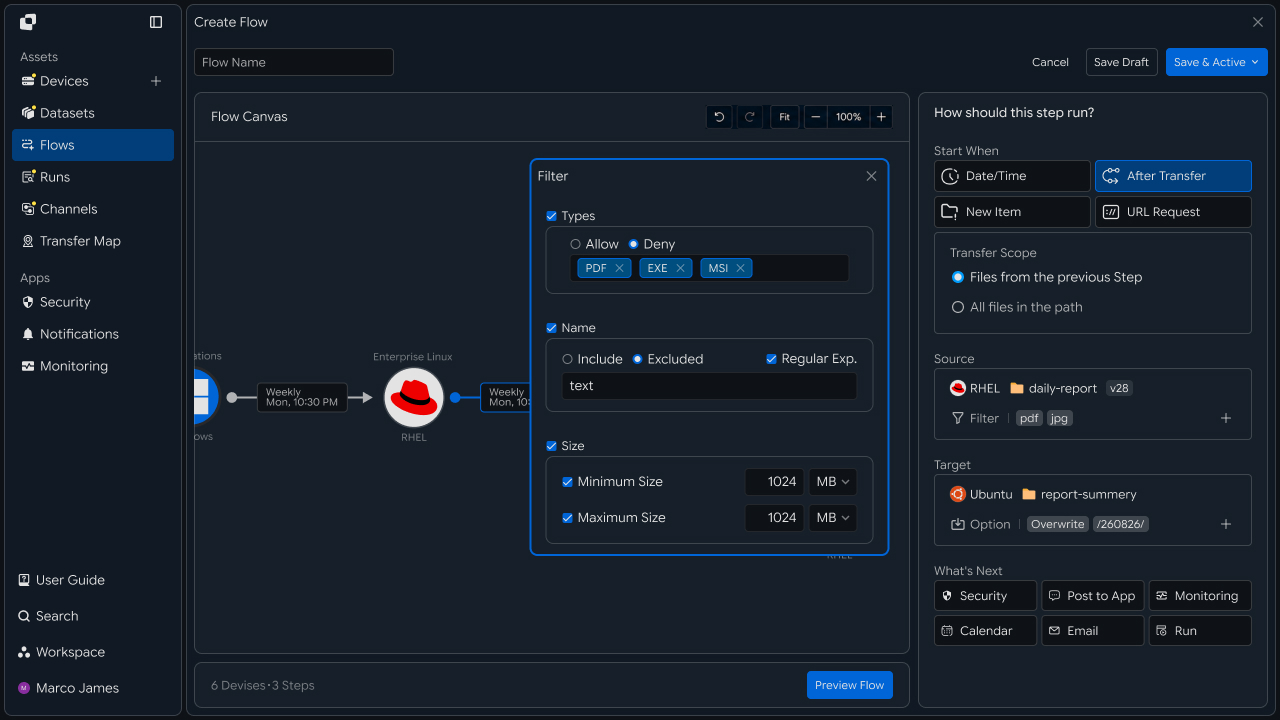
이렇게 하면 모든 파일을 동일한 방식으로 이동하는 대신 파일의 역할에 따라 저장 위치와 이후 활용 환경을 분리할 수 있습니다.
흐름 연결
컨테이너 작업부터 파일 전송과 후속 처리까지 하나의 Flow로 구성하기
결과 파일을 외부 스토리지로 전달한 뒤에는 다음 처리 작업까지 연결할 수 있습니다.
예를 들어 Kubernetes에서 데이터 처리 작업이 완료되면 결과 파일을 S3로 전송하고, 저장이 완료된 이후 분석 Flow나 알림 작업을 실행하도록 구성할 수 있습니다.
┌───────────────┐
│ Kubernetes Job│
└───────┬───────┘
        │ Completed
        ▼
┌───────────────┐
│ Result Files  │
└───────┬───────┘
        │ Transfer
        ▼
┌───────────────┐
│ Amazon S3     │
└───────┬───────┘
        │
        ├──────────────▶ Next Processing
        │
        ├──────────────▶ Analysis
        │
        └──────────────▶ Completion Notice
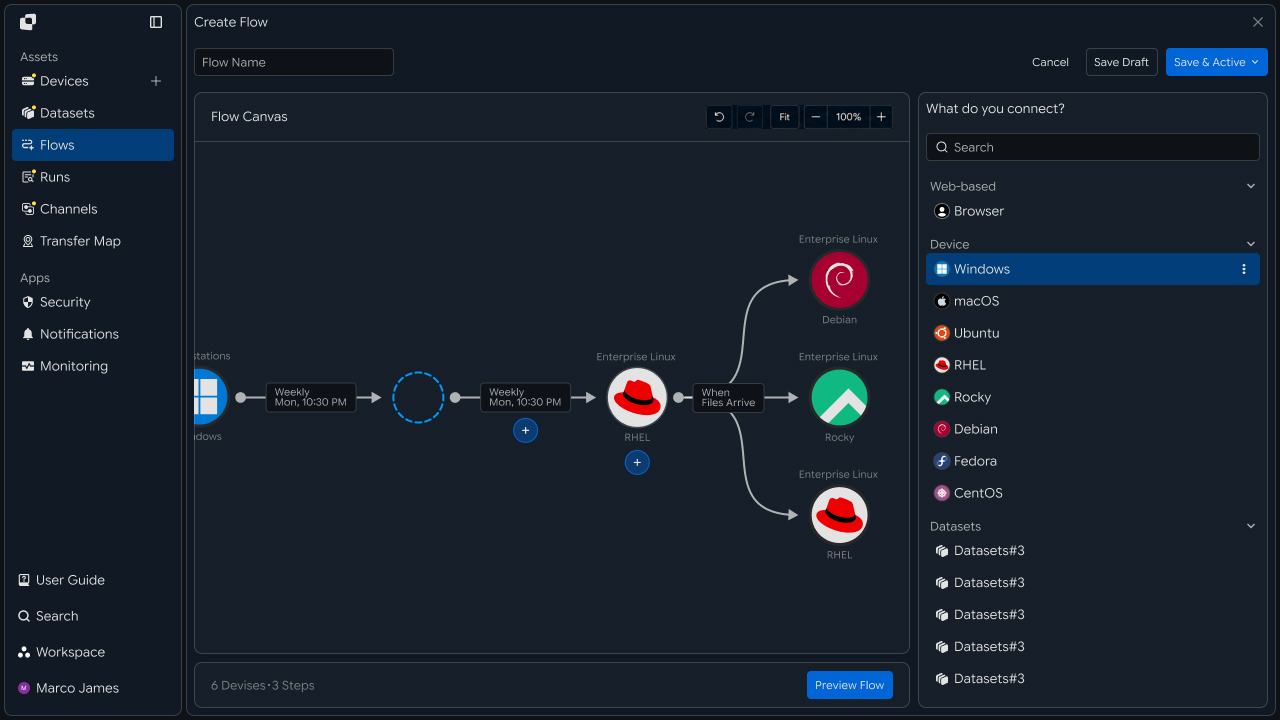
이 구조를 활용하면 컨테이너에서 생성된 파일을 단순히 외부로 복사하는 것을 넘어 워크로드 결과 → 외부 저장 → 분석·후속 처리 → 결과 확인까지 이어지는 자동화 흐름을 구성할 수 있습니다.
실행 관리
워크로드별 파일 전송 결과와 외부 저장 상태를 함께 확인하기
전송 작업이 실행되면 Runs에서 현재 작업 상태와 처리 결과를 확인할 수 있습니다.
특정 Run을 선택하면 Kubernetes Source와 외부 Target, 전송된 파일 수와 전체 용량, 진행 상태와 완료 결과를 확인할 수 있습니다.
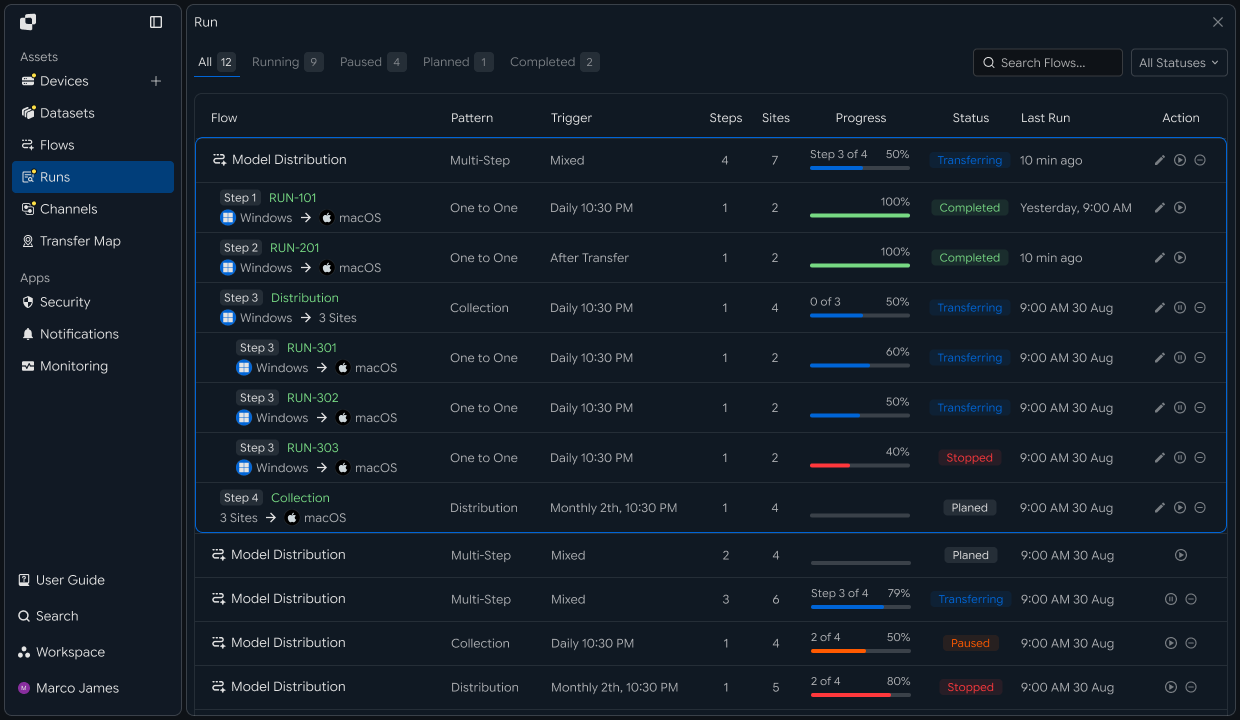
각 Run에서는 다음과 같은 정보를 확인할 수 있습니다.
| 확인 항목 | 확인 내용 |
|---|---|
| Source | Kubernetes 파일 생성 환경과 경로 |
| Target | S3 또는 외부 파일 서버의 저장 위치 |
| Total Files | 처리 대상 파일 수 |
| Total Size | 전체 전송 용량 |
| Progress | 현재 전송 진행 상태 |
| Status | 완료·진행·실패 상태 |
| Started | 작업 시작 시간 |
| Completed | 작업 완료 시간 |
전송이 완료되면 Source에서 선택한 결과 파일이 Target의 지정된 위치에 정상적으로 반영되었는지 확인할 수 있습니다.
이를 통해 어떤 워크로드의 결과가 어느 외부 스토리지로 전달되었는지와 실제 처리 결과를 실행 기록을 기준으로 관리할 수 있습니다.
운영 대응
파일 생성 환경과 외부 Target을 구분해 문제 원인 확인하기
전송 과정에서 추가 확인이 필요한 경우에는 먼저 Kubernetes의 파일 생성 환경과 외부 스토리지 중 어느 구간에서 문제가 발생했는지 확인합니다.
Source에서 파일을 찾을 수 없는 경우에는 워크로드의 결과 파일 생성 상태와 Source 경로를 확인합니다. Target에 파일을 저장할 수 없는 경우에는 외부 스토리지 연결과 저장 경로, 접근 권한을 확인할 수 있습니다.
Transfer Issue
      │
      ▼
 View Run Details
      │
      ├──────────────────┐
      ▼                  ▼
Kubernetes Source    External Target
      │                  │
      │                  │
Workload Status      Storage Connection
Result File Path     Target Path
File Availability    Write Permission
      │                  │
      └────────┬─────────┘
               ▼
        Environment Update
               │
               ▼
             Retry
               │
               ▼
       External Storage Check
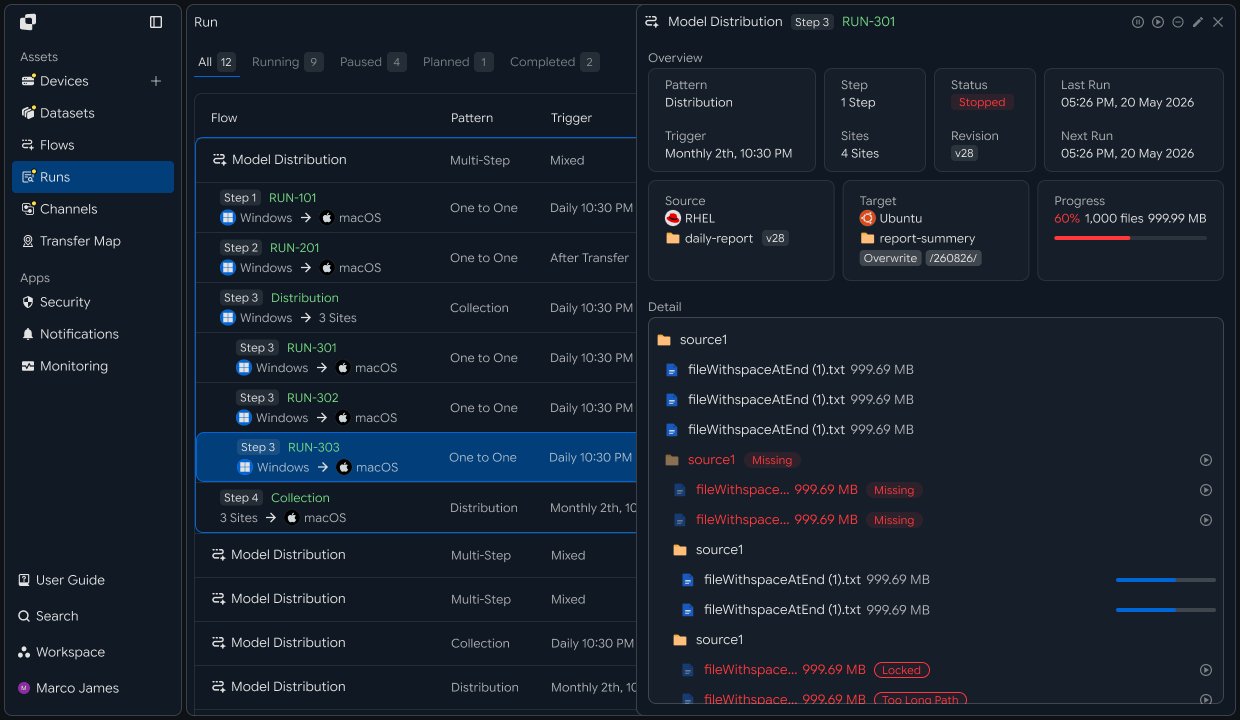
필요한 경로나 연결 환경을 조정한 뒤에는 해당 작업을 다시 실행할 수 있습니다.
재실행 후에는 새로운 Run을 통해 Kubernetes 워크로드에서 생성된 파일이 Amazon S3 또는 외부 파일 서버의 지정된 위치에 정상적으로 반영되었는지 확인합니다.
이 레시피를 적용하면 Kubernetes 파일 생성 환경 연결 → 결과 파일 경로 선택 → S3 또는 외부 파일 서버 Target 구성 → 파일 생성 시점에 맞춘 자동 전송 → 파일 유형별 분기 → 후속 작업 연결 → 실행 결과 확인 → 문제 구간별 재처리까지 하나의 흐름으로 구성할 수 있습니다.
이를 통해 컨테이너 워크로드에서 생성된 결과 파일을 작업 종료 후 별도로 수집하는 대신, Kubernetes의 처리 결과를 외부 스토리지와 직접 연결하고 보관·분석·후속 업무까지 이어지는 파일 전송 자동화 환경을 구성할 수 있습니다.
개발자
클러스터 워크로드의 결과 파일을 외부 스토리지로 전송하기
클러스터 내 에이전트와 외부 대상을 장비로 등록한 뒤, 잡 완료 시 전송 API를 호출합니다. 시작 전에 다음 항목을 준비합니다.
| 준비물 | 내용 |
|---|---|
| INNORIX 인증 | INNORIX_ACCESS_TOKEN (Authorization: Bearer) |
| 소스 장비 | 클러스터 내 에이전트의 device ID와 결과 경로 (예: /data/out) |
| 대상 장비 | S3·파일 서버의 device ID와 저장 경로 (예: results/2026) |
| 런타임 | Python 3 + requests · Java 17+ · Node.js 18+ · .NET 8+ |
Python·Node.js는 REST를 직접 호출하는 최소
api()헬퍼와 상태 상수(STATUS_COMPLETE·TERMINAL)를 API 호출 레시피의 것을 재사용합니다. Java·C#은 번들 소스의InnorixClient(상수 포함)와Json(C#은J) 헬퍼를 사용합니다. 장비 식별자와 경로는 실제 값으로 바꿔 넣습니다.
잡 완료 후 결과 전송
잡이 결과 파일을 다 쓴 뒤(후처리 스텝·완료 훅) 전송을 만들고 종료 상태를 확인합니다.
import time


def transfer_results(source, source_path, target, target_path, action="overwrite"):
    transfer = api("POST", "/api/transfers/manual", {
        "sourceDevice": source,
        "targetDevice": target,
        "targetPath": target_path,
        "sourcePaths": [source_path],
        "sendAllFolder": True,
        "transferOptions": {"target-action": action},
    })
    detail = wait_transfer(transfer["monitorId"])
    return transfer["monitorId"], detail.get("status") == STATUS_COMPLETE


def wait_transfer(monitor_id, timeout=7200, interval=5):
    deadline = time.time() + timeout
    while time.time() < deadline:
        detail = api("GET", f"/api/transfers/{monitor_id}") or {}
        if detail.get("status") in TERMINAL:
            return detail
        time.sleep(interval)
    raise TimeoutError(monitor_id)


monitor_id, ok = transfer_results("k8s-agent", "/data/out", "s3-dst", "results/2026")
print("transfer ok" if ok else "needs check", monitor_id)
에이전트 배치와 접근 전송 시점에 INNORIX 에이전트가 결과 파일이 저장된 볼륨 경로에 접근할 수 있어야 합니다. 에이전트를 Pod·DaemonSet·별도 노드 프로세스 중 어떤 방식으로 배치할지, 결과 볼륨(PVC·hostPath 등)에 어떻게 접근하는지는 제품의 Kubernetes 지원 방식을 따릅니다(클러스터 설정 영역). 전송 코드는 등록된 device ID만 참조합니다.
호출 시점 잡이 결과 파일을 다 쓴 뒤 호출해야 누락 없이 전송됩니다. 잡 완료 훅·후처리 스텝에서 전송 API를 호출하거나, 파일 생성 시 자동 전송이 필요하면 Hot Folder 방식을 검토합니다.
실패 파일은 중단 후 재개 레시피의 retry_failed로 실패분만 다시 전송합니다.
구현 결과
이 레시피를 적용하면 다음 흐름으로 클러스터 결과 파일을 외부로 전송할 수 있습니다.
Kubernetes 워크로드 결과 (/data/out)
   ↓  잡 완료 후 전송 API 호출

INNORIX 전송 (k8s-agent → s3-dst)
   ↓  종료 상태 확인

Amazon S3 / 파일 서버 (results/2026) · 실패 파일만 재시도
컨테이너 워크로드의 결과 파일을 클러스터 외부의 S3나 파일 서버로 전송하고, 실패 파일만 선택해 다시 보낼 수 있습니다.