
EXABYTER
사용자가 늘어나도 파일 전송 때문에 웹 서비스가 흔들리지 않도록 합니다.
대용량 파일을 한 명이 업로드하는 것과 많은 사용자가 동시에 업로드하고 다운로드하는 것은 서로 다른 문제입니다.
사용자가 증가하면 파일 크기뿐 아니라 동시에 유지되는 Transfer의 수, 전체 Traffic, 서버와 Storage의 처리량, 실패와 복구, 사용자별 진행 상태까지 함께 증가합니다. 특히 대용량 파일처럼 하나의 전송이 오랫동안 지속되는 환경에서는 순간적인 접속자 수보다 동시에 얼마나 많은 Transfer가 얼마나 오랫동안 유지되는가가 중요해집니다.
Exabyter는 각각의 파일 전송을 독립적인 Transfer로 처리하고, 서비스 구조에 따라 웹 애플리케이션의 업무 처리와 실제 파일 데이터의 경로를 분리하여 사용자와 전송량이 증가하는 웹 서비스를 확장할 수 있도록 구성합니다.
FROM ONE USER TO MANY
한 명의 대용량 전송과 수많은 동시 전송은 다른 문제입니다.
한 사용자가 100GB 파일 하나를 전송할 때는 해당 Transfer를 얼마나 빠르고 안정적으로 완료할 수 있는지가 중요합니다.
하지만 100명의 사용자가 동시에 대용량 파일을 업로드하거나 다운로드하면 서비스가 처리해야 하는 대상은 하나의 파일이 아닙니다.
각 사용자의 전송은 서로 다른 시점에 시작되고, 서로 다른 네트워크를 사용하며, 전송 속도와 완료 시간도 다릅니다. 일부 Transfer는 정상적으로 완료되는 동안 다른 Transfer에서는 연결 중단이나 Resume이 발생할 수 있습니다.
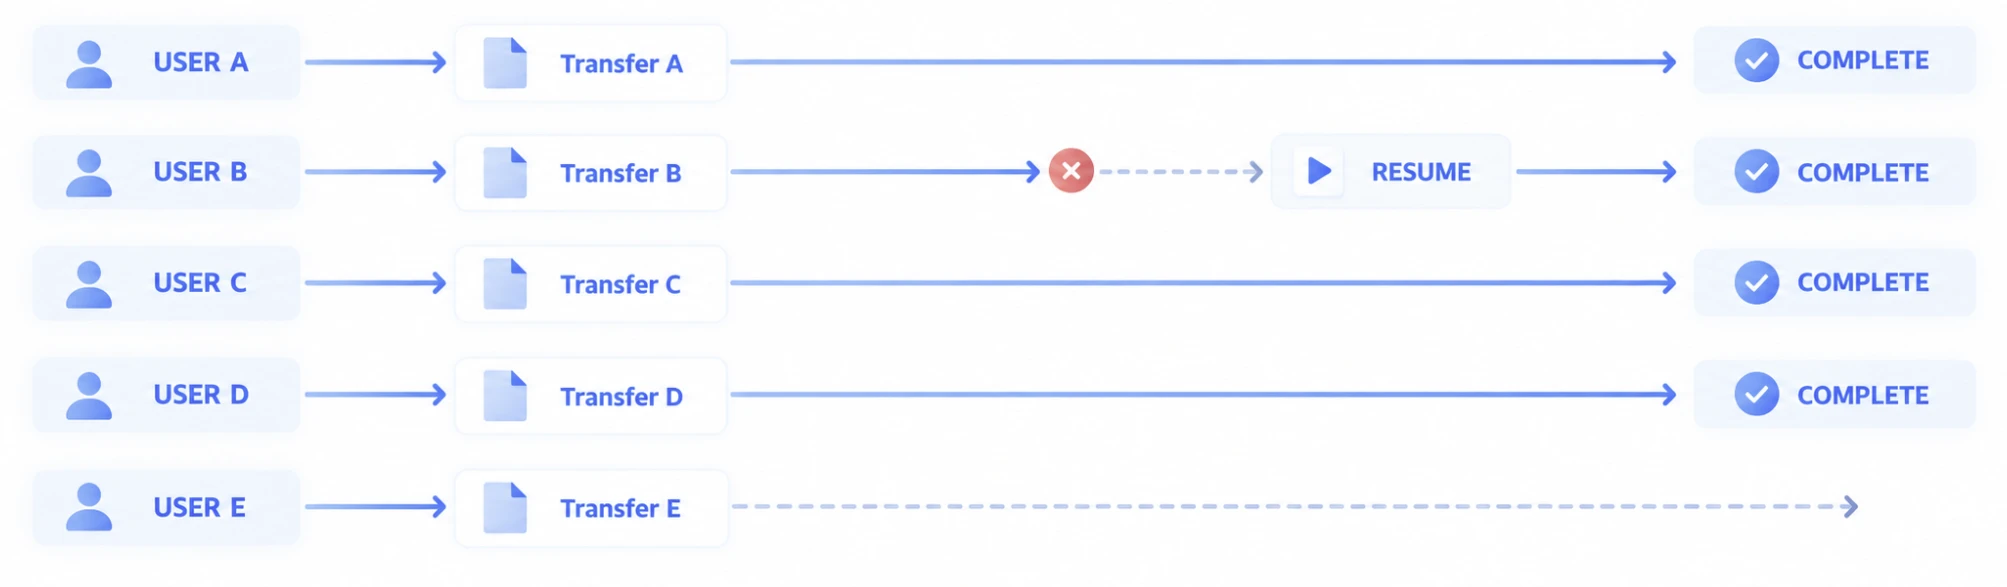
따라서 대규모 웹 파일 전송에서는 전체 사용자를 하나의 Traffic으로 보는 것과 동시에 각각의 Transfer를 독립적으로 유지하는 것이 필요합니다.
CONCURRENT TRANSFERS
여러 사용자의 전송을 각각 독립적으로 처리합니다.
동시에 많은 사용자가 파일을 전송할 때 하나의 Transfer에서 발생한 문제가 다른 사용자의 작업까지 영향을 주어서는 안 됩니다.
각 사용자는 서로 다른 파일과 네트워크 환경을 가지고 있으며 Transfer의 시작, 진행, 중단, 복구와 완료 시점도 다릅니다.
Exabyter는 사용자별 파일 전송을 각각의 Transfer로 처리하여 여러 Upload와 Download가 동시에 진행되는 환경에서도 개별 작업의 상태를 유지할 수 있도록 합니다.
동시에 일어날 수 있는 일
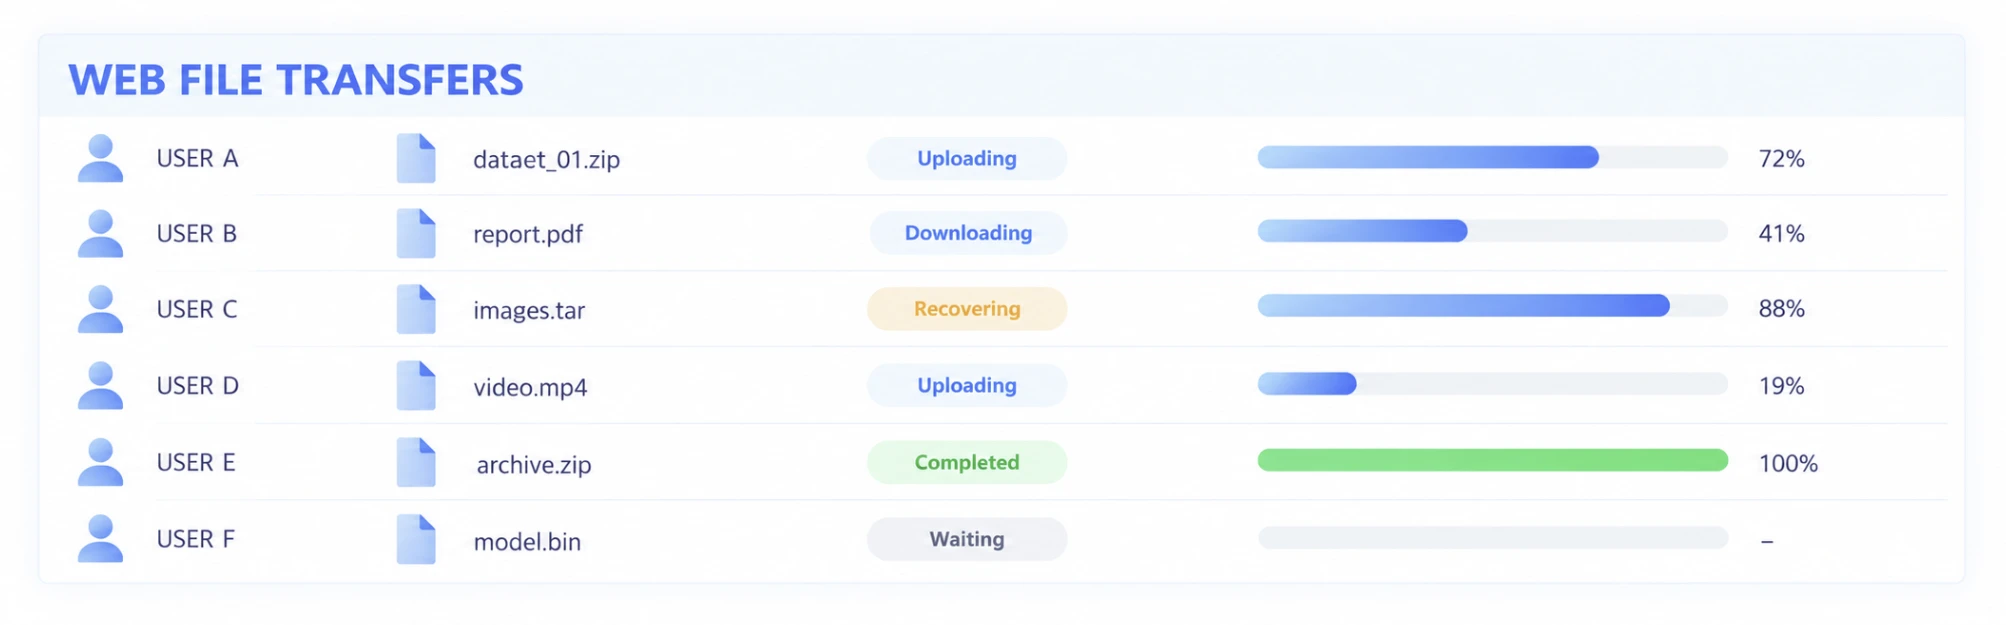
대규모 서비스에서는 단순히 현재 6명이 접속했다가 아니라 각 Transfer가 어떤 상태에 있는가가 실제 서비스 운영에 더 중요한 정보가 됩니다.
LONG-LIVED TRANSFERS
대용량 파일은 웹 요청보다 오래 지속될 수 있습니다.
일반적인 웹 요청은 비교적 짧은 시간 안에 처리되고 종료됩니다.
반면 대용량 파일 Transfer는 파일 크기와 네트워크 상태에 따라 훨씬 오랫동안 지속될 수 있습니다. 여러 사용자의 장시간 Transfer가 동시에 발생하면 웹 서비스는 단순한 요청 수뿐 아니라 오랫동안 유지되는 데이터 전송 작업을 함께 처리해야 합니다.
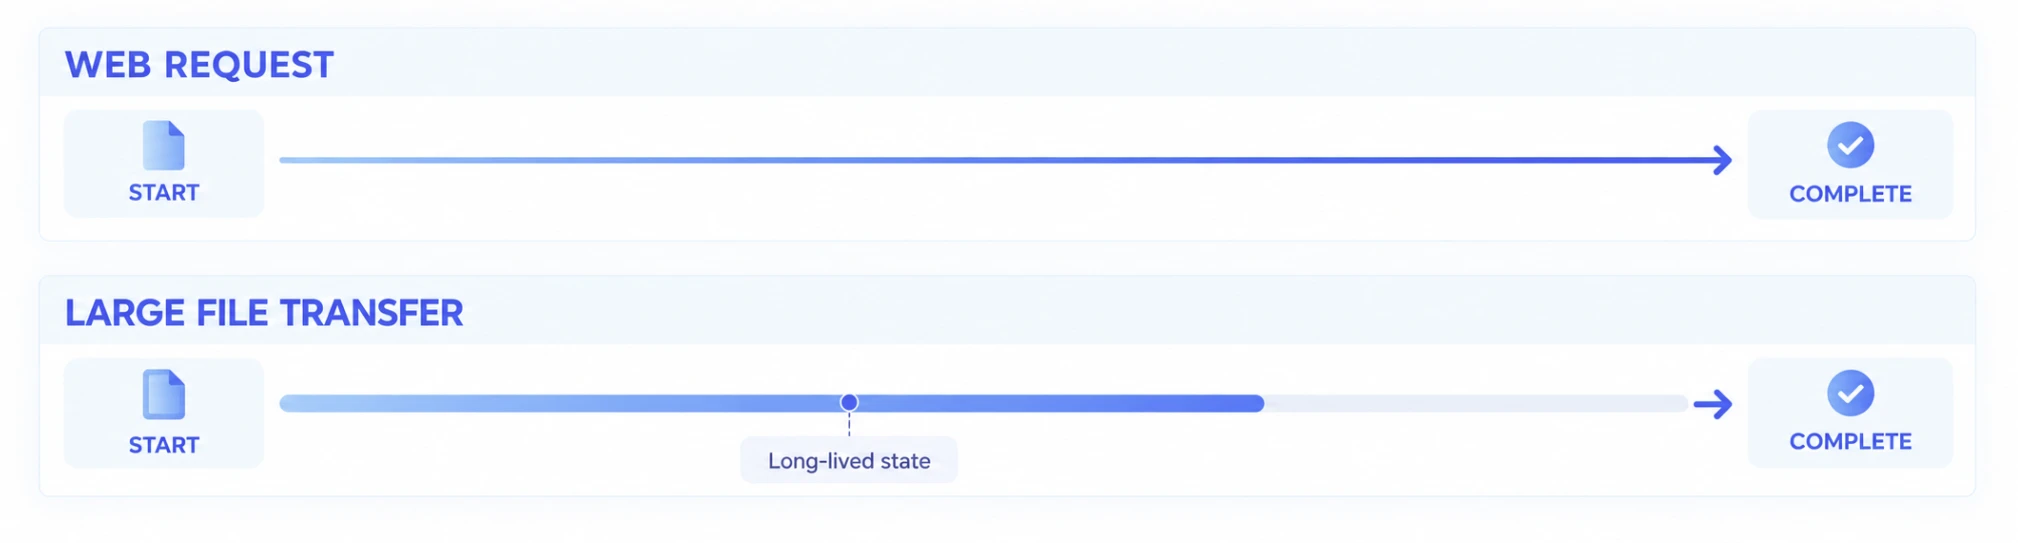
따라서 대규모 웹 파일 전송에서는 각각의 Transfer 상태를 장시간 유지하고, 연결 변화나 중단이 발생하더라도 해당 작업을 이어갈 수 있는 구조가 중요합니다.
TRAFFIC SURGE
사용자가 몰릴 때 파일 Traffic도 함께 증가합니다.
웹 서비스의 Traffic 증가는 페이지 조회나 API Request 증가만을 의미하지 않습니다.
파일 업로드와 다운로드가 포함된 서비스에서는 사용자 증가와 함께 실제로 이동하는 데이터의 양도 빠르게 증가할 수 있습니다.
예를 들어 한 사용자가 10GB를 업로드하는 환경에서 동일한 시간대에 수십 명 또는 수백 명이 Transfer를 시작하면 웹 서비스는 일반적인 업무 요청과 함께 대규모 File Traffic을 처리해야 합니다.
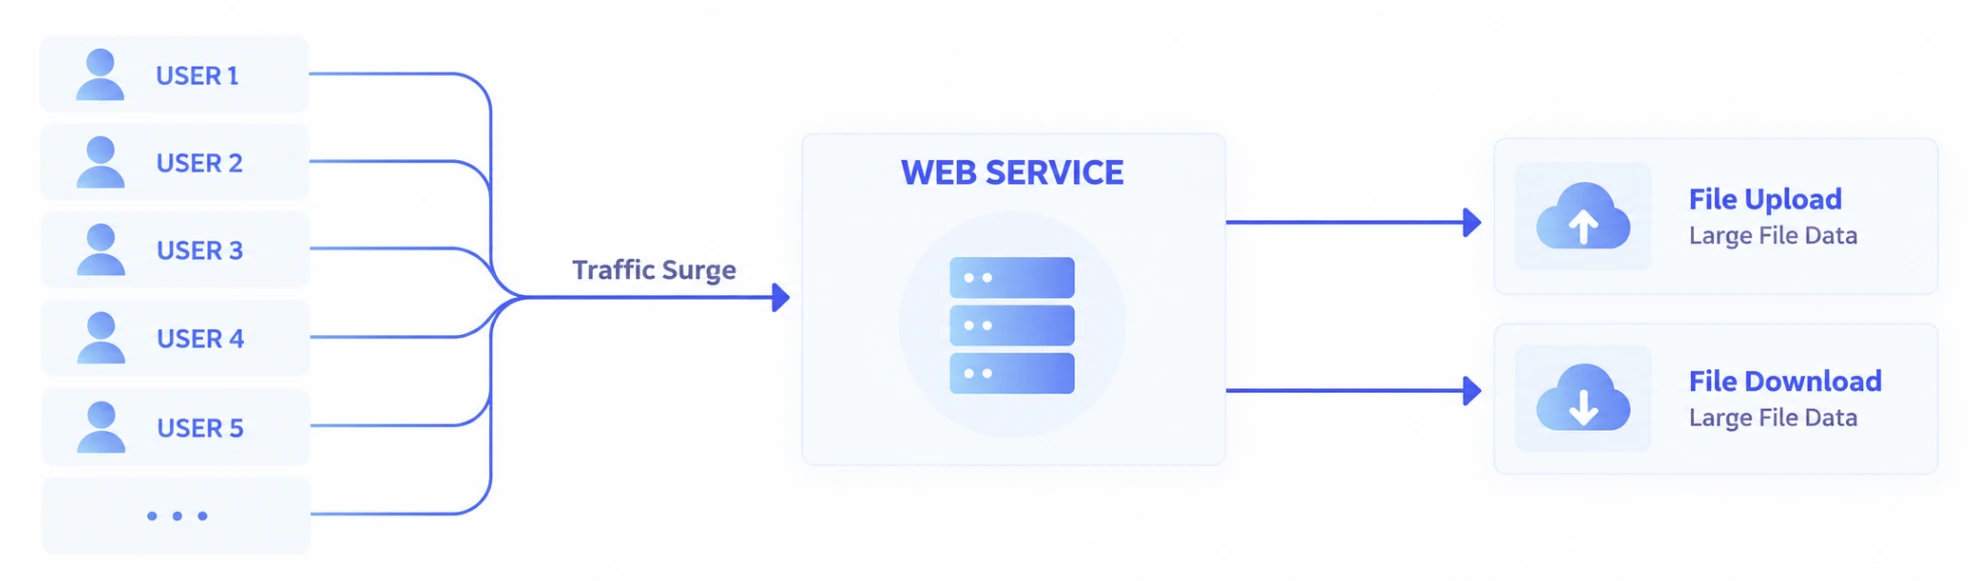
대규모 파일 서비스에서는 이러한 Traffic Surge를 단순히 서버 한 대의 성능 문제로 보지 않고 웹 업무와 파일 데이터가 각각 어떤 자원을 사용하는지를 함께 봐야 합니다.
WEB TRAFFIC & FILE TRAFFIC
웹 업무와 파일 데이터는 서로 다른 특성을 가집니다.
웹 애플리케이션은 인증, 권한, 화면, API, Metadata와 업무 로직을 처리합니다.
파일 Transfer는 실제 대용량 데이터를 장시간 읽고 전송하고 저장합니다.
두 작업은 같은 웹 서비스 안에서 시작되더라도 사용하는 자원의 성격과 확장 방식이 다를 수 있습니다.
| Web Application | File Transfer |
|---|---|
| Authentication | Large Data |
| Authorization | Long-lived Transfer |
| Business Logic | Upload / Download |
| API | Throughput |
| Metadata | Resume / Recovery |
| Short Requests | Long-running Data Flow |
이 차이를 고려하지 않고 모든 파일 데이터를 Web Application과 동일한 경로에서 처리하면 파일 Traffic의 증가가 웹 업무 처리에 영향을 줄 수 있습니다.
SEPARATE THE DATA PATH
웹 서비스와 파일 데이터의 경로를 분리할 수 있습니다.
서비스 규모가 커질수록 애플리케이션의 역할과 실제 파일 데이터의 이동을 분리하는 구성이 유리할 수 있습니다.
웹 애플리케이션은 사용자 인증, 권한, Metadata와 업무 상태를 담당하고 대용량 파일 데이터는 별도의 Transfer 경로를 통해 전송하도록 구성할 수 있습니다.
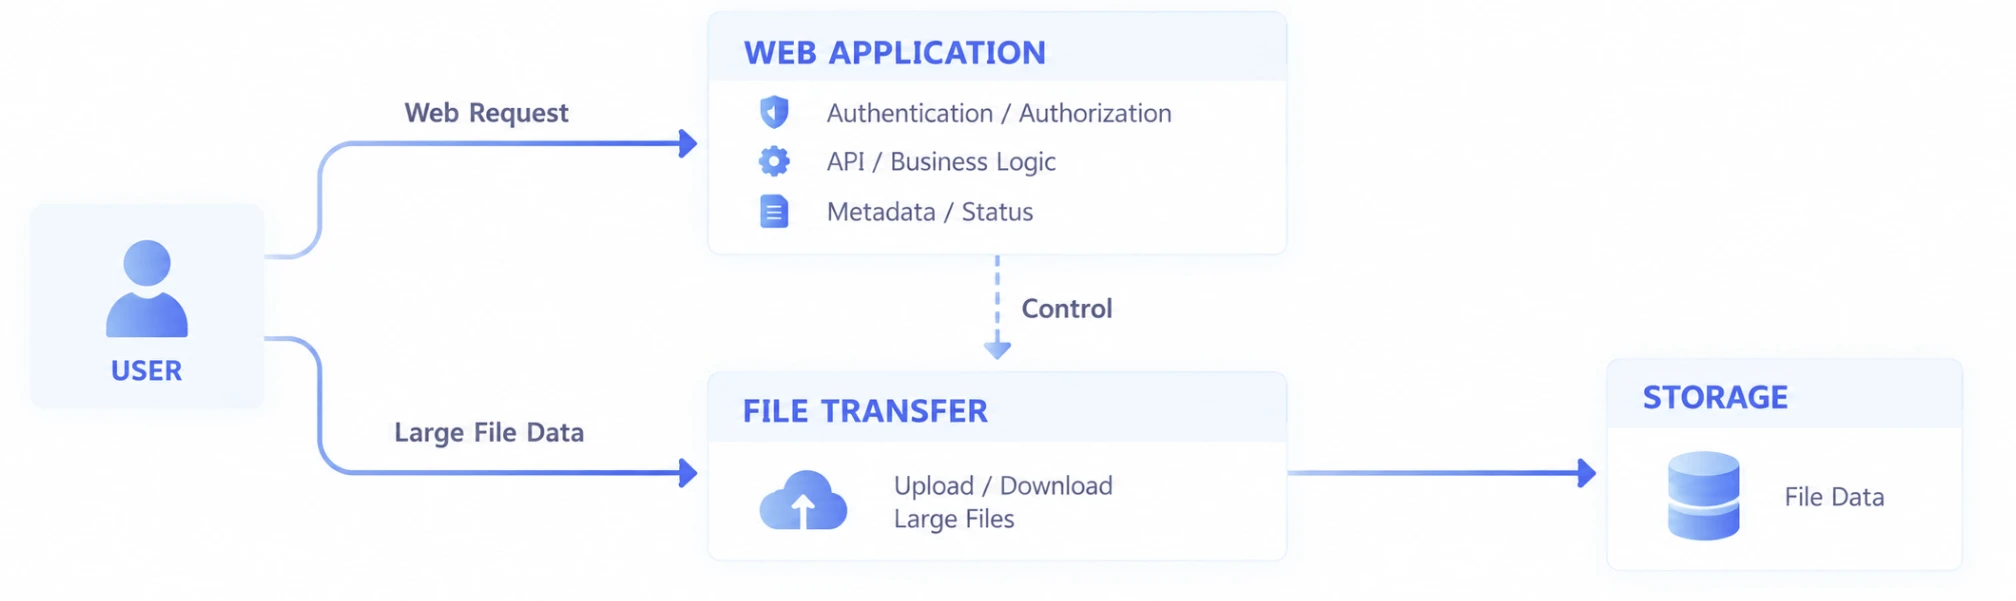
이 구조에서는 웹 애플리케이션이 모든 파일 바이트를 직접 처리하는 대신 각 영역을 목적에 맞게 구성할 수 있습니다.
웹 서비스는 업무를 처리하고, Transfer 경로는 파일 데이터를 전송합니다.
TWO WAYS TO SCALE
기존 구조를 유지하거나 데이터 경로를 분리할 수 있습니다.
모든 서비스가 처음부터 새로운 아키텍처로 만들어질 필요는 없습니다.
Exabyter는 기존 웹 애플리케이션 구조에 파일 전송 기능을 적용하는 방식과, 서비스 규모와 데이터 구조에 따라 파일 데이터의 경로를 분리하는 방식 모두를 고려할 수 있습니다.
기존 Web Server 중심 구성

기존 인증, 권한, 업무 로직과 저장 구조를 유지하면서 대용량 Upload / Download를 적용합니다.
기존 기업 업무 시스템이나 현재 운영 중인 웹 서비스에 파일 전송 기능을 추가할 때 적합한 구성입니다.
파일 데이터 경로를 분리한 구성
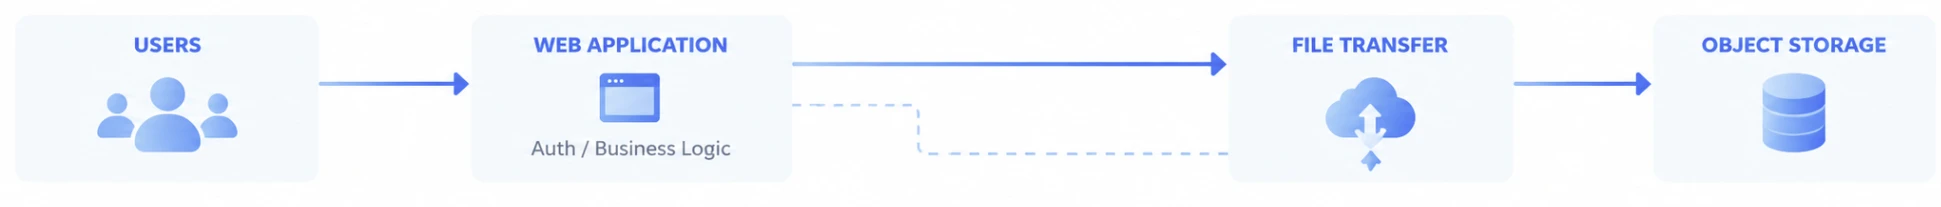
웹 애플리케이션과 대용량 파일 데이터의 역할을 분리하여 각각의 요구에 맞게 확장할 수 있습니다.
서비스의 구조, 기존 시스템, 데이터 규모와 이후 파일의 사용 방법에 따라 적합한 방식을 선택할 수 있습니다.
OBJECT STORAGE
대규모 파일 데이터는 저장 구조도 함께 확장할 수 있습니다.
파일 전송량이 증가하면 파일을 전송하는 경로뿐 아니라 데이터를 저장하는 위치와 방식도 중요해집니다.
Object Storage를 사용하는 환경에서는 웹 애플리케이션이 인증과 업무 로직을 처리하고 실제 파일 데이터는 별도의 Transfer 경로를 통해 Storage와 연결하도록 구성할 수 있습니다.
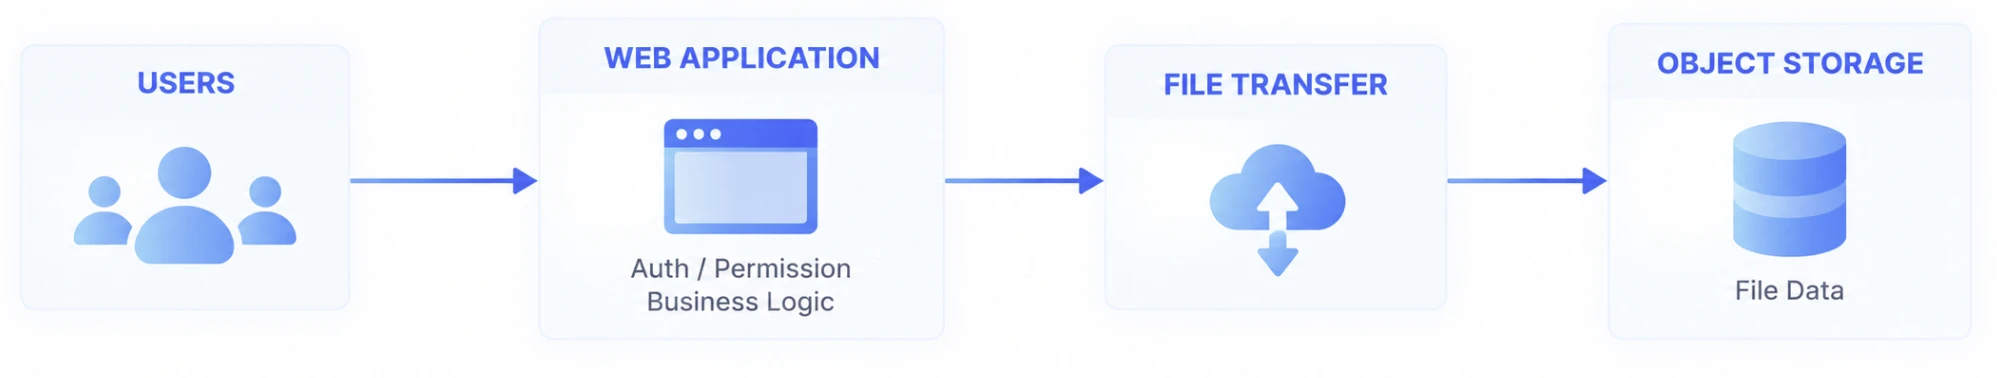
이러한 구조에서는 애플리케이션의 업무 처리와 대규모 파일 저장, 전송을 서로 다른 요구에 맞게 설계할 수 있습니다.
또한 Object Storage에 도착한 파일을 이후 다른 서버, 스토리지 또는 처리 시스템으로 연결해야 하는 환경으로 확장할 수도 있습니다.
구체적인 Web Server / Object Storage 구성과 이후 시스템 연계는 아키텍처 및 연동 페이지에서 자세히 설명합니다.
TRAFFIC CONTROL
모든 Transfer가 동시에 같은 자원을 경쟁할 필요는 없습니다.
대규모 파일 서비스에서는 가능한 모든 Transfer를 무조건 최대 속도로 실행하는 것이 항상 최선은 아닙니다.
여러 사용자가 동시에 대용량 Upload와 Download를 수행하면 네트워크, Storage와 Endpoint의 처리 용량을 함께 사용합니다. 특정 시간대에 Transfer가 급격하게 증가하면 전체 서비스의 자원 사용을 고려한 운영이 필요할 수 있습니다.
서비스 환경에 따라 다음과 같은 조건을 고려할 수 있습니다.
- 동시에 진행되는 Transfer의 수
- Upload와 Download의 Traffic
- 사용 가능한 Network Bandwidth
- Storage Read / Write 성능
- Endpoint 처리 용량
- 업무 시간대와 대규모 전송 시간대
- 사용자 또는 서비스별 전송 요구
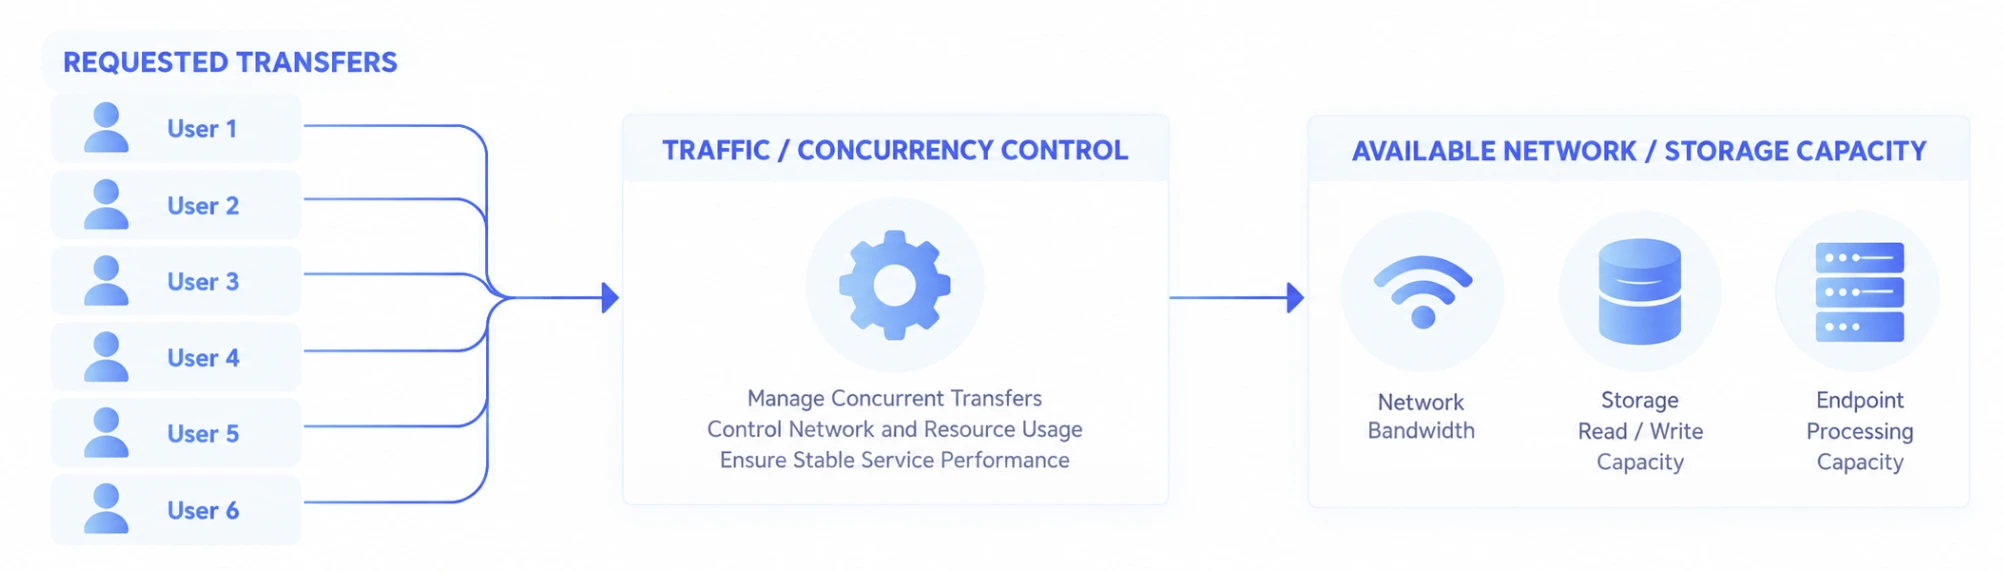
목적은 단순히 Transfer의 수를 제한하는 것이 아니라 파일 전송량이 증가해도 전체 서비스가 예측 가능한 범위 안에서 동작하도록 구성하는 것입니다.
TRANSFER ISOLATION
한 사용자의 문제를 전체 서비스의 문제로 만들지 않습니다.
동시 사용자가 많은 환경에서는 일부 사용자의 네트워크가 느리거나 연결이 중단될 수 있습니다.
이때 하나의 Transfer에서 발생한 지연이나 복구가 다른 사용자의 정상적인 Transfer까지 중단시키지 않도록 각각의 작업을 독립적으로 유지하는 것이 중요합니다.
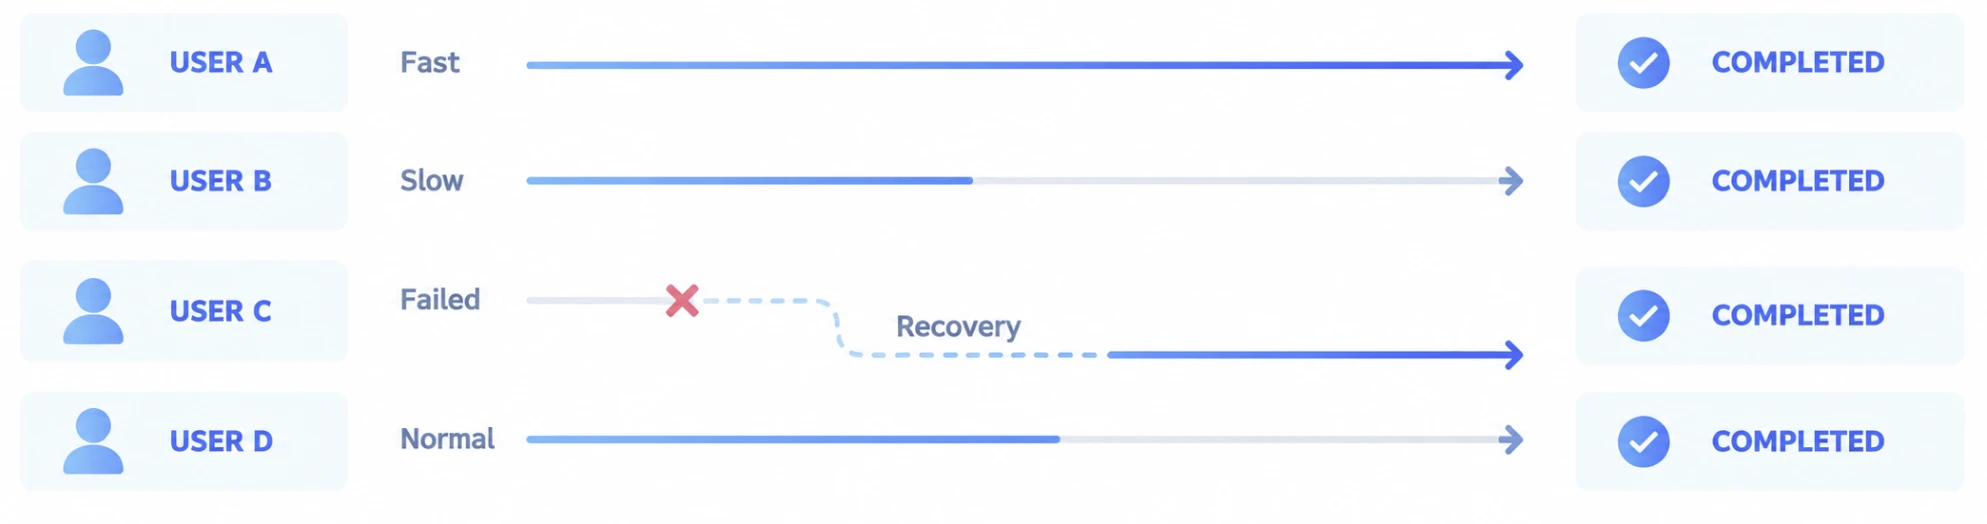
사용자마다 네트워크와 파일이 달라도 각각의 Transfer는 자신의 상태에 따라 진행됩니다.
이러한 분리는 외부 사용자, 원격 근무자, 여러 지역의 지사처럼 서로 다른 네트워크 조건의 사용자가 하나의 서비스를 함께 이용하는 환경에서 특히 중요합니다.
SCALE EACH LAYER
서비스의 병목이 어디에 있는지에 따라 확장합니다.
대규모 웹 파일 전송의 성능은 하나의 서버 사양만으로 결정되지 않습니다.
사용자 수가 증가하면 Web Application, Transfer 처리, Network, Storage 각각에서 서로 다른 병목이 발생할 수 있습니다.
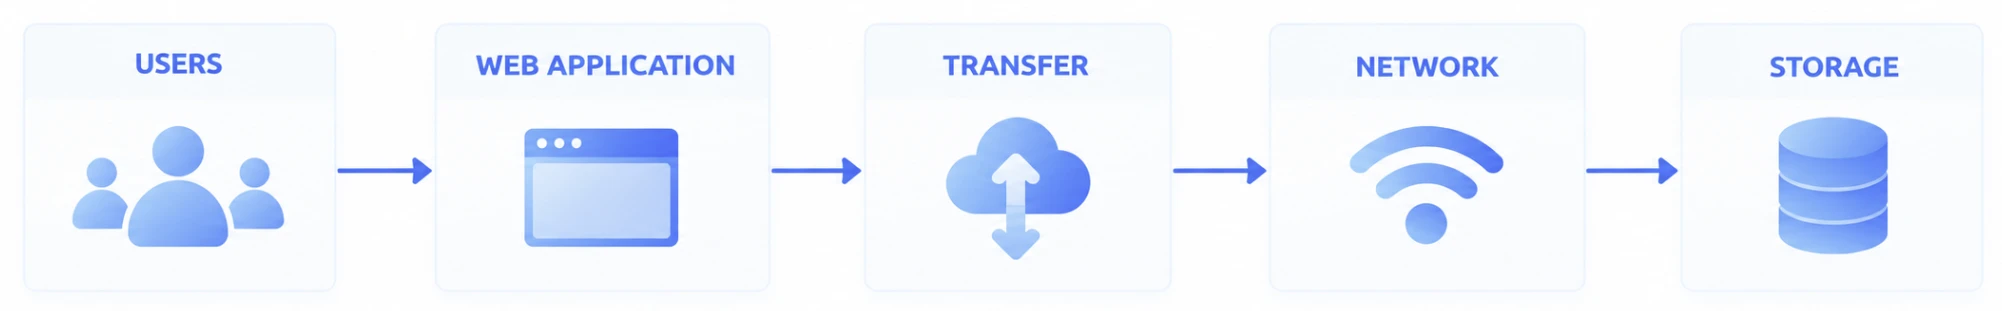
따라서 확장할 때는 전체 시스템을 한 번에 크게 만드는 것보다 실제 병목이 발생하는 영역을 확인하는 것이 중요합니다.
Web Application
인증, 권한, API와 업무 처리량
Transfer
동시에 유지되는 Upload / Download와 장시간 Transfer
Network
전체 File Traffic과 가용 Bandwidth
Storage
동시 Read / Write, 파일 수와 저장 처리량
각 영역의 역할이 분리된 구조에서는 서비스 성장에 따라 필요한 부분을 중심으로 확장할 수 있습니다.
UPLOAD & DOWNLOAD AT SCALE
대규모 서비스에서는 Upload와 Download가 동시에 발생합니다.
파일 기반 웹 서비스는 Upload만 제공하는 경우보다 양방향 데이터 흐름을 가지는 경우가 많습니다.
사용자가 원본 파일을 업로드하고 처리된 결과를 다시 다운로드하거나, 기업이 대용량 자료를 여러 사용자에게 제공하면서 동시에 새로운 데이터를 수집할 수 있습니다.
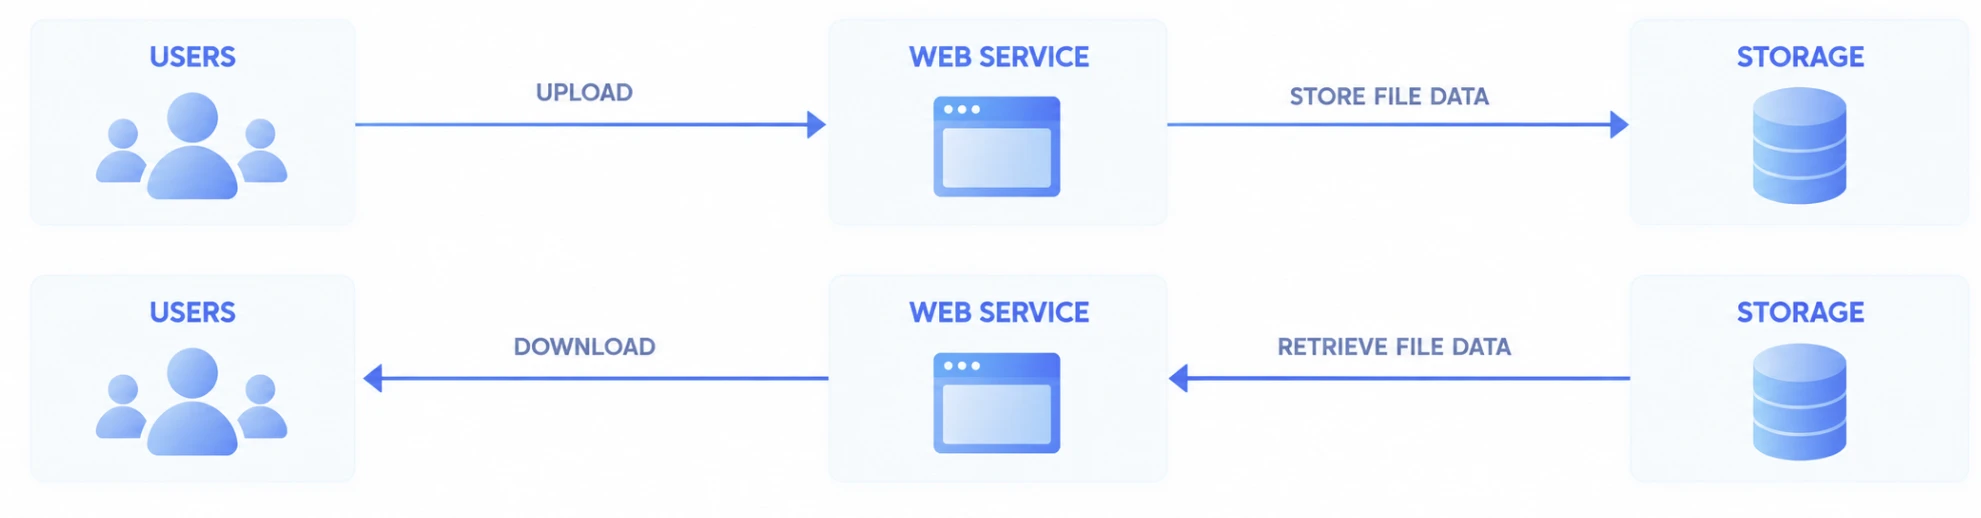
따라서 서비스 규모를 설계할 때는 한 방향의 최대 Traffic뿐 아니라 Upload와 Download가 동시에 발생하는 실제 사용 패턴을 고려해야 합니다.
AFTER THE UPLOAD
사용자 증가와 데이터 증가를 함께 생각합니다.
웹 서비스가 성장하면 사용자의 수만 증가하는 것이 아닙니다.
업로드된 파일의 양도 계속 증가하고, 파일이 Storage에 도착한 이후 처리, 분석, 보관 또는 다른 시스템으로 전송해야 하는 데이터 흐름도 함께 커질 수 있습니다.
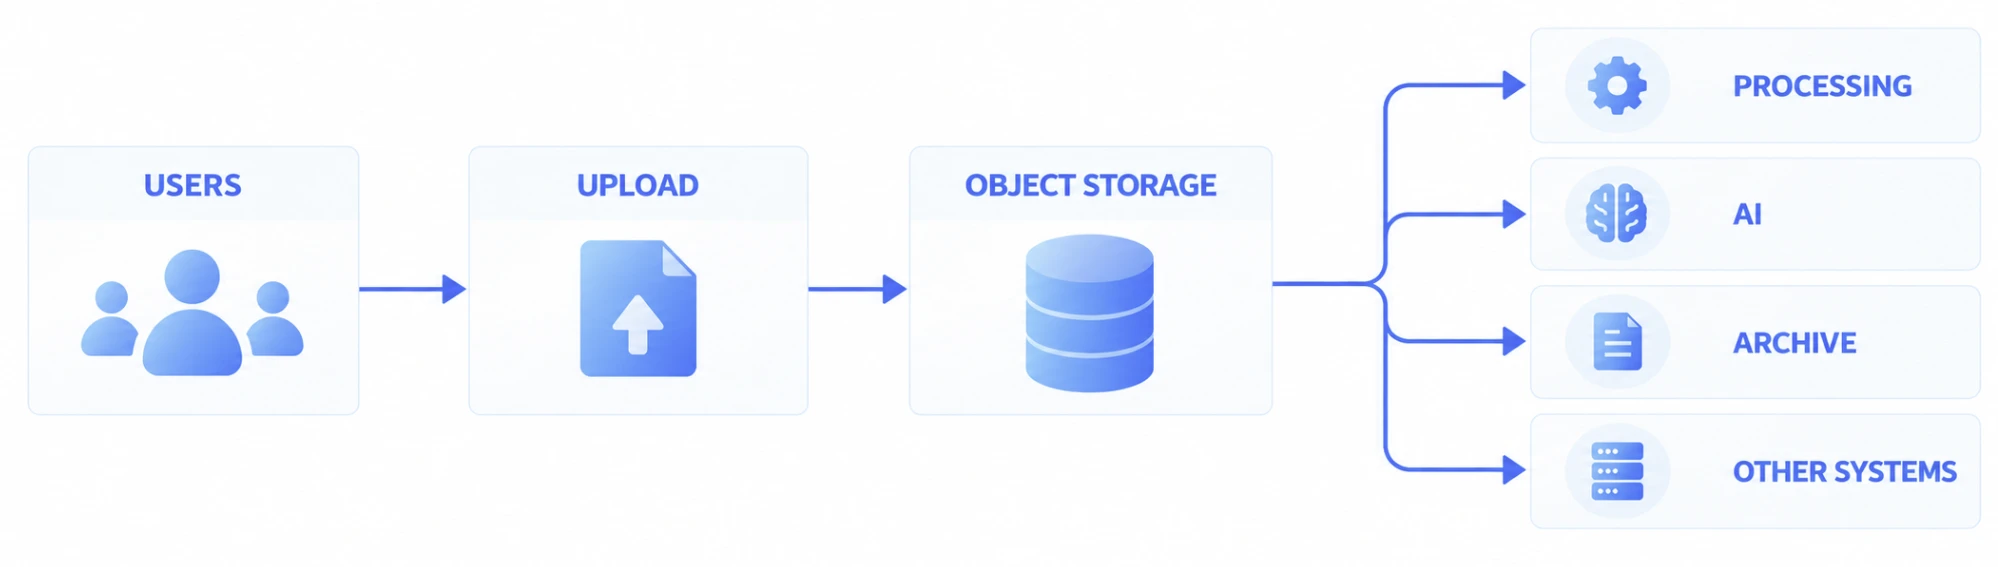
대규모 환경에서는 웹 Upload를 최종 목적지로 보는 대신 더 큰 데이터 Workflow의 진입점으로 설계할 수 있습니다.
반대로 다른 시스템에서 생성된 대규모 데이터를 Storage로 수집하고 이를 웹 사용자의 Download로 연결하는 구조도 가능합니다.
OPERATING AT SCALE
전송이 많아질수록 상태와 결과를 확인할 수 있어야 합니다.
몇 개의 Transfer는 개별 사용자의 화면만으로도 확인할 수 있습니다.
하지만 동시에 많은 Transfer가 진행되는 환경에서는 현재 얼마나 많은 작업이 진행 중인지, 어떤 전송이 완료되었는지, 실패하거나 복구 중인 Transfer가 있는지를 서비스 관점에서 확인할 필요가 생깁니다.
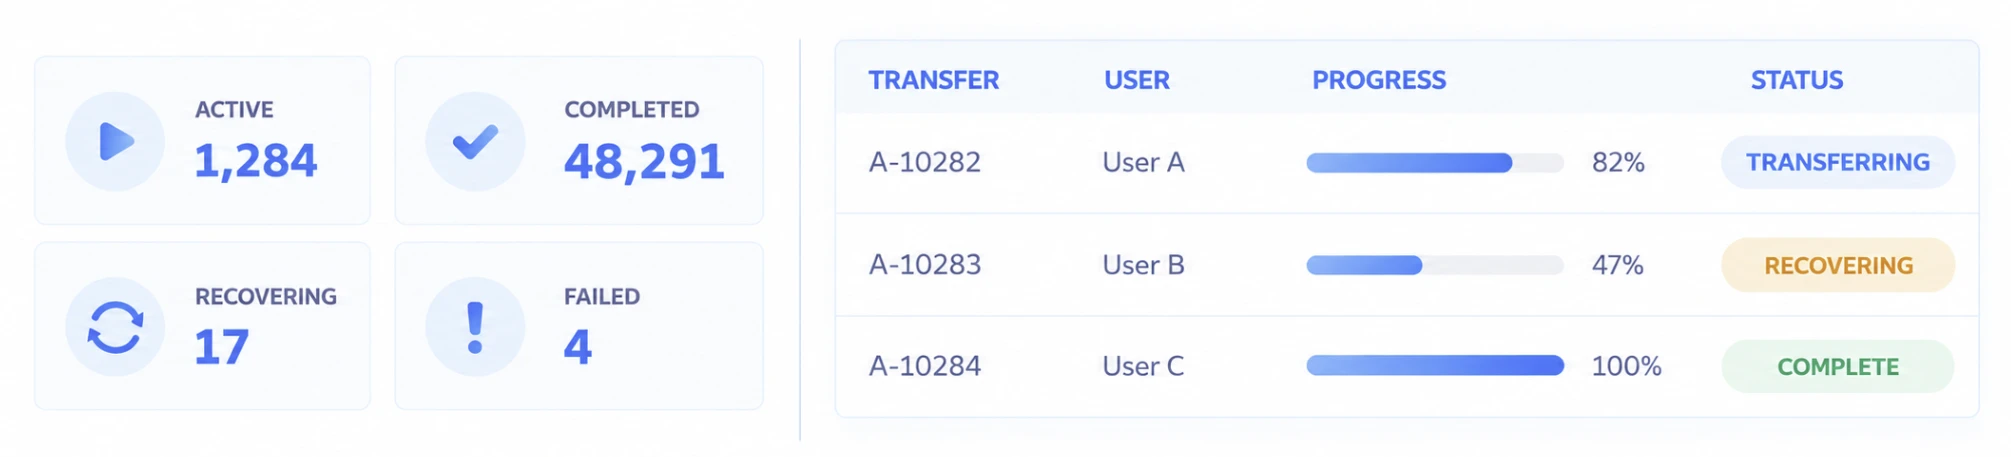
필요한 운영 환경에서는 여러 Transfer의 상태와 결과, 과거 이력을 확인하고 웹에서 시작해 다른 시스템으로 이어지는 파일 흐름까지 함께 운영할 수 있습니다.
구체적인 운영 방식은 운영 및 관리 페이지에서 자세히 설명합니다.
CAPACITY PLANNING
동시 사용자 수보다 실제 Transfer 조건을 확인해야 합니다.
대규모 웹 파일 전송 서비스를 설계할 때 몇 명까지 사용할 수 있는가라는 하나의 숫자만으로 필요한 규모를 결정하기는 어렵습니다.
같은 1,000명의 사용자라도 한 번에 10MB 파일을 보내는 서비스와 100GB 파일을 장시간 전송하는 서비스는 필요한 Network와 Storage 용량이 전혀 다릅니다.
실제 설계에서는 다음 조건을 함께 확인해야 합니다.
| 확인 항목 | 이유 |
|---|---|
| Concurrent Users | 같은 시간대에 실제 전송하는 사용자 수 |
| Concurrent Transfers | 동시에 유지되는 Transfer 수 |
| Average File Size | 일반적인 전송 데이터 규모 |
| Maximum File Size | 가장 오래 지속될 수 있는 Transfer |
| File Count | 파일별 처리와 Storage I/O 영향 |
| Upload / Download Ratio | 양방향 Traffic 규모 |
| Peak Traffic | 특정 시간대의 최대 전송량 |
| Available Bandwidth | 실제 사용할 수 있는 네트워크 용량 |
| Storage Performance | 동시 Read / Write 처리량 |
| Transfer Duration | 동시에 유지되는 작업 수에 영향 |
이러한 조건을 기준으로 현재 환경에서 필요한 Transfer와 인프라 규모를 설계할 수 있습니다.
USE CASES
많은 사용자가 큰 파일을 다루는 웹 서비스에 적용합니다.
공공, 기업 대민 서비스
신청, 제출, 자료 등록과 결과 다운로드가 특정 시간대에 집중되는 웹 서비스를 구성합니다.
고객, 파트너 포털
외부 사용자가 서로 다른 네트워크에서 대용량 자료를 Upload하고 결과물을 Download하는 서비스를 제공합니다.
Media Portal
여러 제작자와 고객이 동시에 고해상도 영상과 프로젝트 데이터를 업로드하고 다운로드합니다.
Research Platform
연구자들이 대용량 Dataset을 제출하고 처리된 결과를 다시 받는 서비스를 구성합니다.
AI & Data Service
여러 사용자가 Dataset과 대규모 데이터를 Object Storage로 전송하고 이후 Processing 또는 AI Workflow로 연결합니다.
Enterprise File Service
조직 내 여러 부서와 외부 사용자가 하나의 웹 서비스를 통해 대용량 파일을 주고받는 환경을 구성합니다.
RELATED
서비스 규모와 함께 파일과 아키텍처를 확인하세요.
대용량, 대량 파일 전송
큰 파일, 수많은 파일과 폴더를 하나의 Transfer로 어떻게 처리하는지 확인하세요.
자세히 보기고속, 안정적 파일 전송
장거리, Latency, Packet Loss와 연결 변화가 많은 동시 Transfer에 어떤 영향을 주는지 알아보세요.
자세히 보기아키텍처 및 연동
기존 Web Server와 Object Storage를 이용하여 Web Traffic과 File Traffic의 경로를 어떻게 구성하는지 확인하세요.
자세히 보기운영 및 관리
많은 Transfer의 상태와 결과, 실패와 복구, 과거 이력을 어떻게 확인하고 운영하는지 알아보세요.
자세히 보기자주 묻는 질문
많은 사용자가 동시에 대용량 파일을 업로드하면 어떤 문제가 발생할 수 있나요?
동시에 유지되는 Transfer와 전체 File Traffic이 증가하면서 Network, Web Server, Transfer 처리 영역과 Storage의 부하가 함께 증가할 수 있습니다. 특히 장시간 대용량 Transfer에서는 단순 접속자 수보다 동시에 진행되는 Transfer 수와 각 Transfer의 데이터 규모를 함께 고려해야 합니다.
대용량 파일 업로드가 웹 서비스 성능에 영향을 줄 수 있나요?
파일 데이터와 일반 웹 요청이 동일한 자원을 사용하면 File Traffic 증가가 웹 애플리케이션의 업무 처리에 영향을 줄 수 있습니다. 서비스 구조에 따라 인증, 업무 처리와 실제 대용량 파일 데이터의 경로를 분리하여 각각의 요구에 맞게 구성할 수 있습니다.
웹 서버를 거치지 않고 Object Storage로 대용량 파일을 전송할 수 있나요?
서비스 구조에 따라 웹 애플리케이션은 인증, 권한과 업무 처리를 담당하고 실제 파일 데이터는 별도의 Transfer 경로를 통해 Object Storage와 연결하도록 구성할 수 있습니다. 구체적인 방식은 기존 시스템과 Storage, 보안 및 업무 요구에 따라 설계합니다.
동시 사용자가 증가하면 서버만 추가하면 되나요?
항상 그렇지는 않습니다. 병목은 Web Application, Transfer, Network 또는 Storage 중 서로 다른 위치에서 발생할 수 있습니다. Concurrent Transfers, 파일 크기, Upload / Download 비율, Network Bandwidth와 Storage I/O를 함께 확인한 뒤 필요한 영역을 확장하는 것이 중요합니다.
한 사용자의 느린 네트워크가 다른 사용자의 전송에도 영향을 주나요?
대규모 파일 전송에서는 각 사용자의 Transfer 상태를 독립적으로 유지하는 것이 중요합니다. 사용자마다 파일 크기와 네트워크 상태가 다르므로 느리거나 복구 중인 Transfer와 정상적으로 진행되는 다른 Transfer를 각각 처리할 수 있도록 구성합니다.
대규모 파일 전송 서비스의 용량은 무엇을 기준으로 산정해야 하나요?
전체 가입자 수만으로 산정하기보다 실제 동시 사용자와 Concurrent Transfers, 평균, 최대 파일 크기, 파일 수, Upload / Download 비율, Peak Traffic, Network Bandwidth와 Storage 성능을 함께 확인해야 합니다.
업로드된 파일을 이후 다른 시스템으로 자동으로 연결할 수 있나요?
대규모 서비스에서는 웹 Upload를 데이터 흐름의 시작점으로 구성할 수 있습니다. Storage에 도착한 파일을 처리 서버, AI, Archive 또는 다른 시스템으로 이어서 전송하거나, 반대로 다른 시스템에서 수집한 데이터를 웹 Download로 연결하는 구성이 가능합니다.