
시작하기#
기본 개념#
중간 저장 없이 S3 데이터를 Cloudflare R2로 직접 이전하기
S3에 저장된 데이터를 R2로 이전할 때는 전체 데이터를 한 번에 이동할 수도 있고, 특정 Bucket이나 업무별 Prefix만 선택해 단계적으로 이전할 수도 있습니다.
기존에는 다음과 같이 중간 환경을 거쳐 파일을 이동할 수 있습니다.
Amazon S3
    │
    │ Download
    ▼
Local PC / Server
    │
    │ Upload
    ▼
Cloudflare R2
이 방식은 중간 환경의 저장 공간과 파일 관리가 추가될 수 있습니다.
직접 전송을 구성하면 S3와 R2를 하나의 전송 경로로 연결할 수 있습니다.
┌──────────────────┐
│    Amazon S3     │
│                  │
│  Source Bucket   │
└────────┬─────────┘
         │
         │ Direct Transfer
         ▼
┌──────────────────┐
│   Cloudflare R2   │
│                  │
│  Target Bucket   │
└──────────────────┘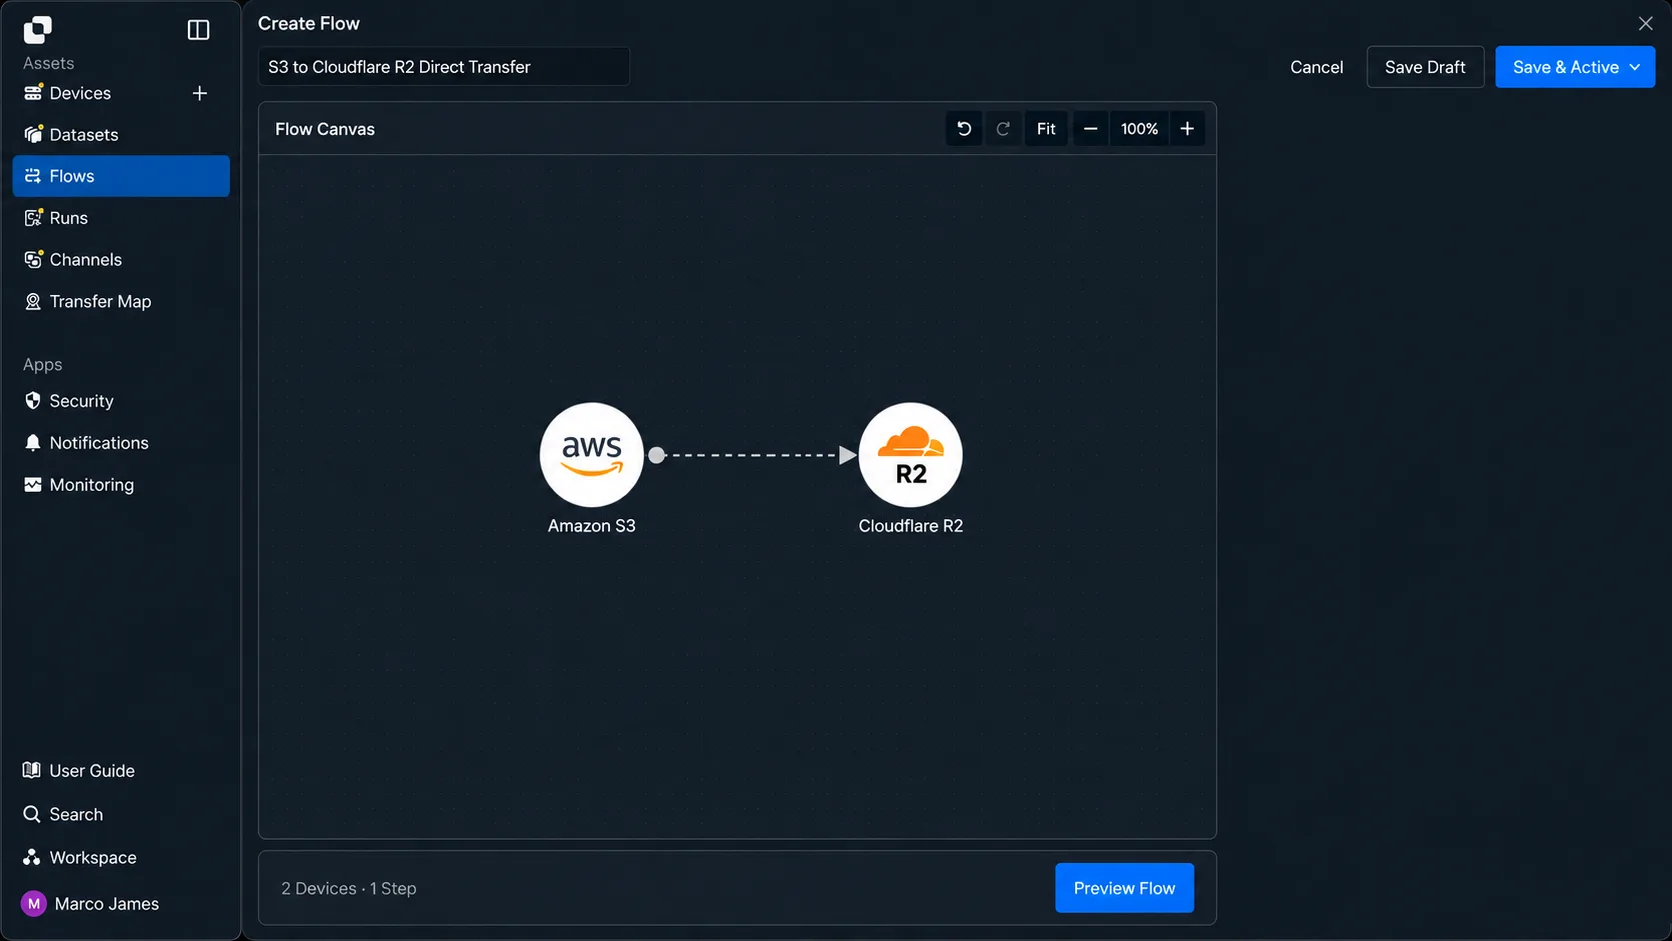
이렇게 하면 S3 파일 선택 → R2 직접 전송 → 이전 결과 확인 → 파일 검증까지 하나의 흐름으로 관리할 수 있습니다.
이전 범위#
전체 Bucket 또는 필요한 데이터 경로를 선택해 이전하기
S3 Bucket에는 서비스 데이터, 백업 파일, 로그와 임시 파일처럼 서로 다른 목적의 파일이 함께 저장될 수 있습니다.
따라서 전체 Bucket을 그대로 이전하는 대신 실제 R2 환경에서 필요한 데이터만 선택할 수 있습니다.
예를 들어 S3에 다음과 같은 구조가 있다고 가정합니다.
source-bucket
│
├── media/
│   ├── original/
│   └── processed/
│
├── backup/
│   ├── daily/
│   └── archive/
│
├── logs/
│
└── temporary/
이 중 media/와 backup/만 R2로 이전하도록 구성할 수 있습니다.
Amazon S3                         Cloudflare R2

source-bucket                     migration-bucket
│                                 │
├── media/         ───────────▶   ├── media/
│                                 │
├── backup/        ───────────▶   ├── backup/
│                                 │
├── logs/          Not Included   │
│                                 │
└── temporary/     Not Included   │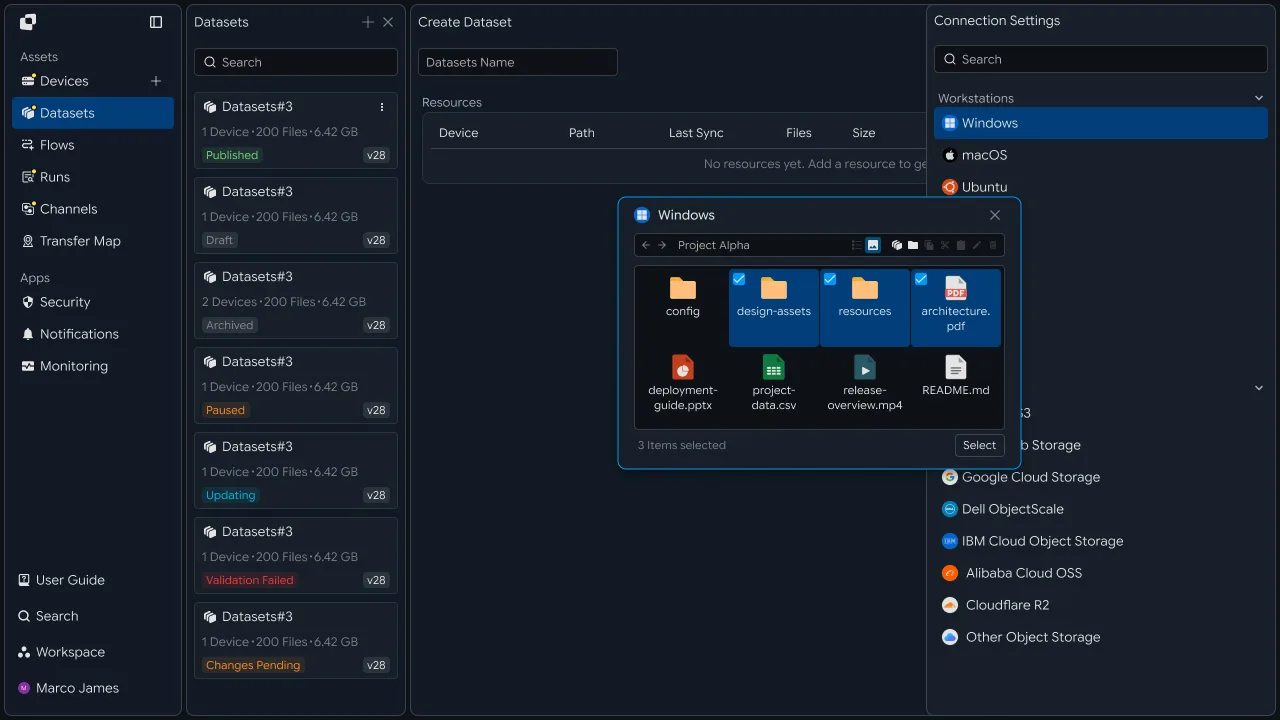
이전 범위는 데이터의 종류와 이전 목적에 따라 구분할 수 있습니다.
| 설정 기준 | 활용 |
|---|---|
| Source Bucket | 이전할 S3 Bucket 지정 |
| Source 경로 | 특정 Prefix 또는 폴더 선택 |
| Target Bucket | R2의 대상 Bucket 지정 |
| Target 경로 | 이전 파일을 저장할 위치 구성 |
| 파일 조건 | 특정 확장자나 이름 규칙 선택 |
| 제외 조건 | 임시 파일이나 불필요한 경로 제외 |
이를 통해 전체 데이터를 무조건 이동하는 방식이 아니라 필요한 파일을 기준으로 단계적인 이전 작업을 구성할 수 있습니다.
이전 단계#
기존 데이터를 먼저 이동하고 변경 파일을 이어서 반영하기
대량의 데이터를 이전하는 경우 기존 파일과 이전 중 새로 생성되는 파일을 같은 방식으로 처리할 필요는 없습니다.
먼저 기존 데이터를 R2로 이전하고, 초기 이전이 완료될 때까지 S3에서 새로 생성되거나 변경되는 파일을 이후에 추가 반영하는 방식으로 구성할 수 있습니다.
전체 흐름은 다음과 같이 나눌 수 있습니다.
① 이전 범위 확인
        │
        ▼
② 기존 파일 전송
        │
        ▼
③ 파일 수·용량 비교
        │
        ▼
④ 변경 파일 확인
        │
        ▼
⑤ 추가 파일 반영
        │
        ▼
⑥ 최종 검증
이 방식은 초기 대량 전송과 이후 변경 사항을 분리해 관리할 수 있다는 점에서 대규모 파일 이전에 적합합니다.
예를 들어 서비스에서 계속 파일이 생성되는 경우 다음과 같이 구성할 수 있습니다.
Initial Migration
S3 Existing Files
        │
        ▼
Cloudflare R2
        │
        └────── Initial Result

Sync Migration
S3 New / Changed Files
        │
        ▼
Cloudflare R2
        │
        └────── Final Result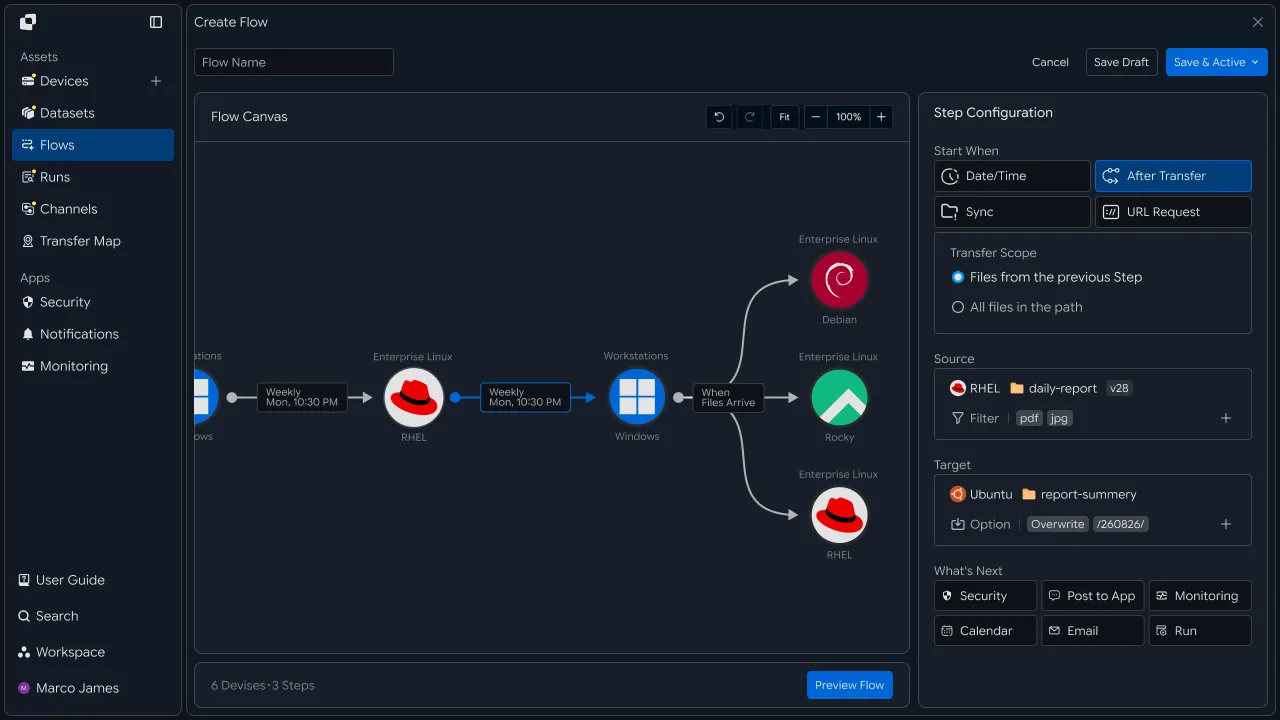
이렇게 하면 기존 데이터를 먼저 이전한 뒤 서비스 운영 중 발생한 변경 파일을 추가로 반영해 최종 전환 시점의 데이터 차이를 줄일 수 있습니다.
IT 엔지니어#
스토리지 연결#
Amazon S3와 Cloudflare R2를 각각 전송 환경에 등록하기
먼저 이전할 데이터를 저장하고 있는 Amazon S3와 새로운 저장 환경으로 사용할 Cloudflare R2를 각각 연결합니다.
Source와 Target은 서로 다른 오브젝트 스토리지이므로 파일을 읽는 범위와 저장하는 범위를 각각 관리합니다.
S3에서는 이전할 Bucket과 파일을 읽을 수 있어야 하며, R2에서는 대상 Bucket과 지정된 경로에 파일을 저장할 수 있어야 합니다.
Object Storage Connections

Amazon S3
└── Source Bucket
    └── Read Files

Cloudflare R2
└── Target Bucket
    └── Write Files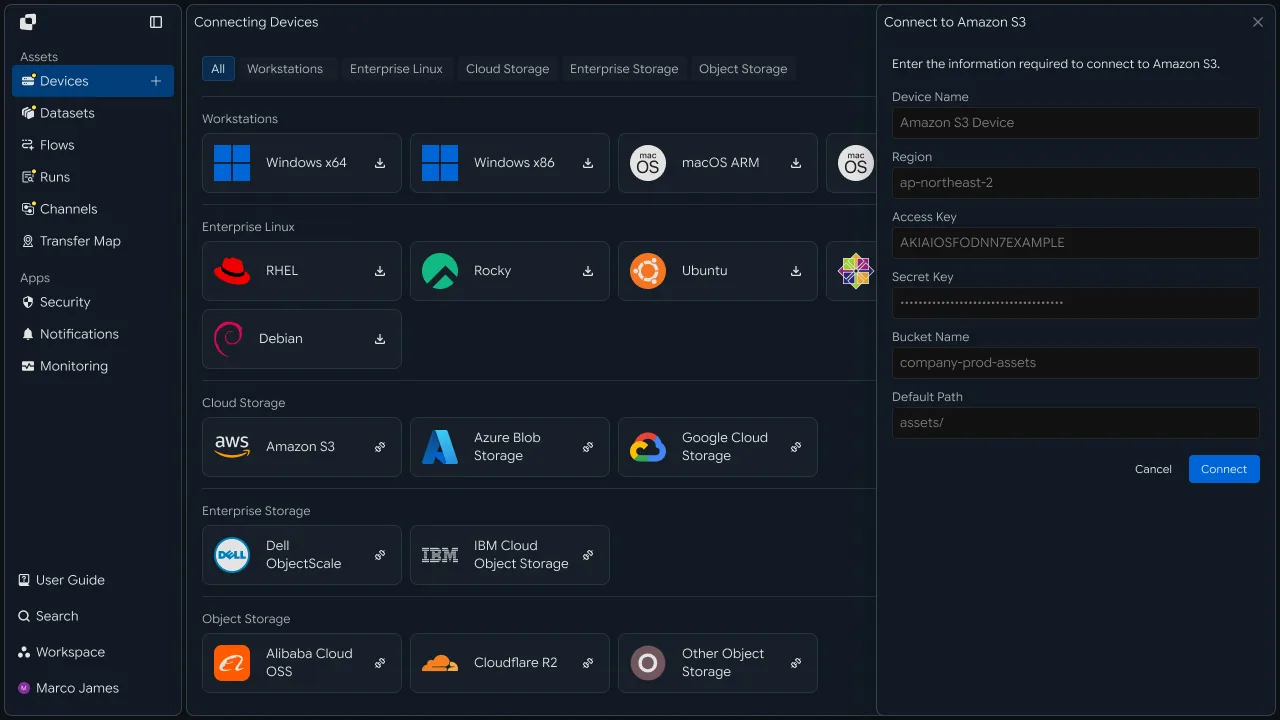
이전 작업을 시작하기 전에 다음 항목을 확인합니다.
| 구분 | 확인 내용 |
|---|---|
| S3 연결 | Source Bucket 접근 상태 |
| Source 권한 | 이전 파일과 경로 읽기 가능 여부 |
| R2 연결 | Target Storage 연결 상태 |
| Target Bucket | 이전 파일을 저장할 Bucket 확인 |
| 저장 권한 | R2에 파일을 생성하고 저장할 수 있는지 확인 |
| 전송 경로 | Source와 Target의 이전 범위 확인 |
각 Storage의 연결 범위를 분리하면 Source의 원본 데이터 접근과 Target의 저장 환경을 독립적으로 관리하면서 하나의 Flow로 연결할 수 있습니다.
경로 설계#
S3의 파일 구조를 R2의 운영 구조에 맞춰 이전하기
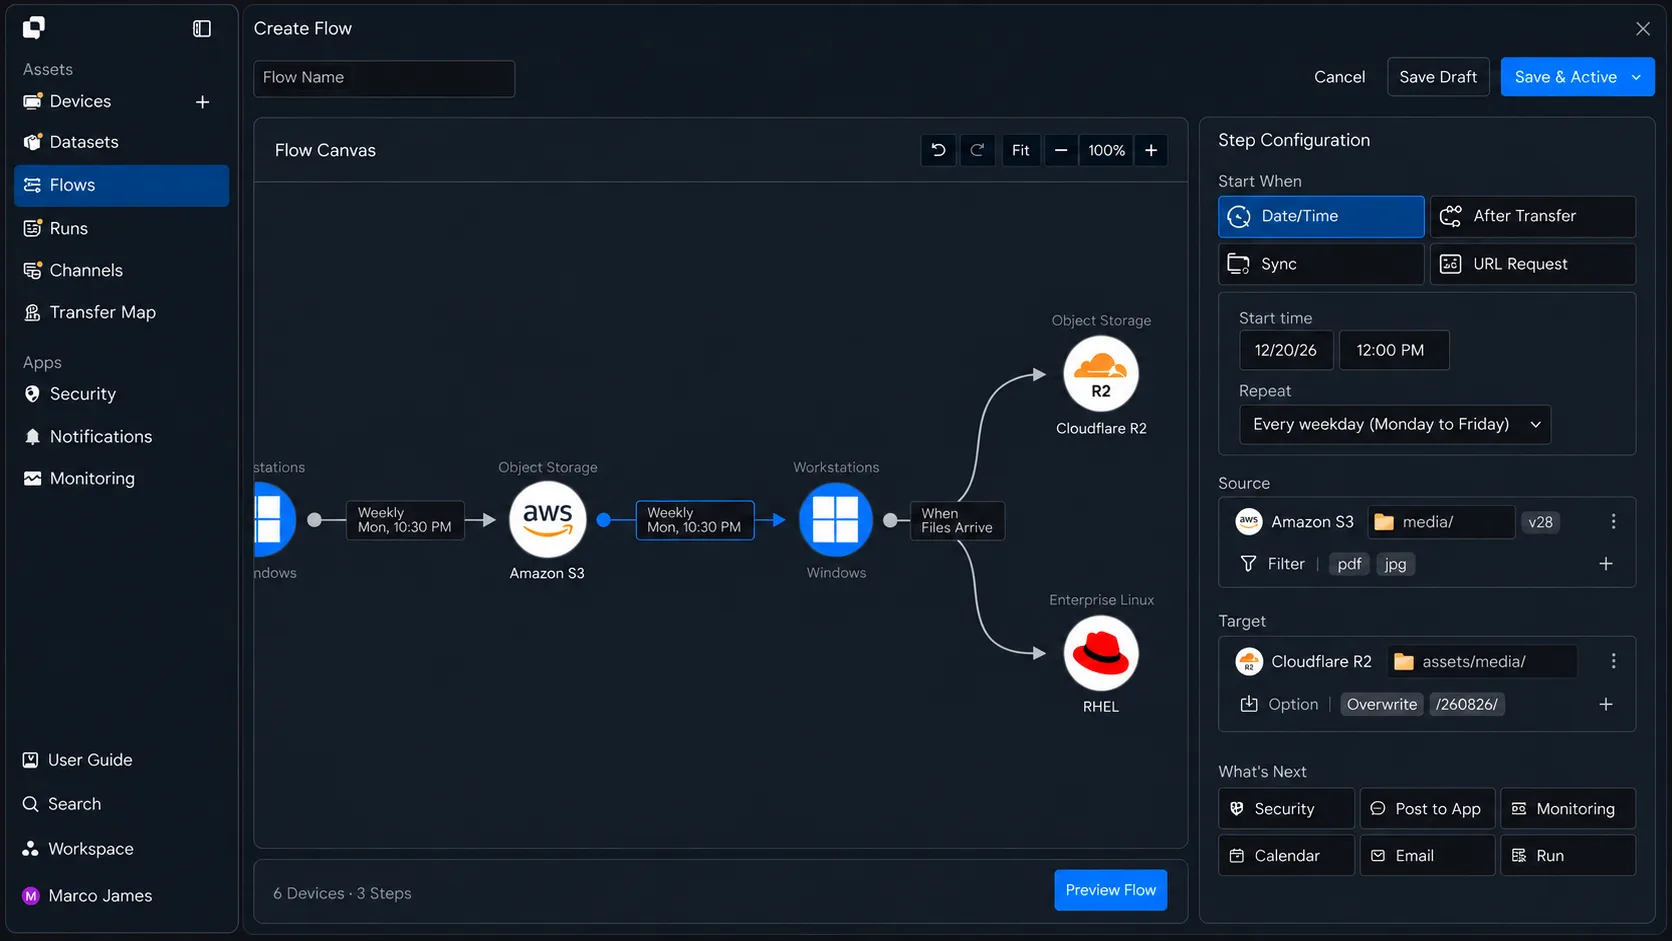
스토리지 연결이 완료되면 S3에서 파일을 가져올 경로와 R2에서 파일을 저장할 위치를 설정합니다.
단순히 동일한 파일 구조를 유지할 수도 있지만, 이전 과정에서 새로운 운영 환경에 맞게 Target 구조를 변경할 수도 있습니다.
예를 들어 S3의 다음 경로를 Source로 사용할 수 있습니다.
s3://source-bucket/media/processed/R2에서는 다음 위치를 Target으로 지정할 수 있습니다.
r2://migration-bucket/assets/media/파일 이동 구조는 다음과 같이 구성됩니다.
Amazon S3
source-bucket
└── media/
    └── processed/
        ├── video-001.mp4
        ├── video-002.mp4
        └── image-001.jpg

              │
              │ Migration
              ▼

Cloudflare R2
migration-bucket
└── assets/
    └── media/
        ├── video-001.mp4
        ├── video-002.mp4
        └── image-001.jpg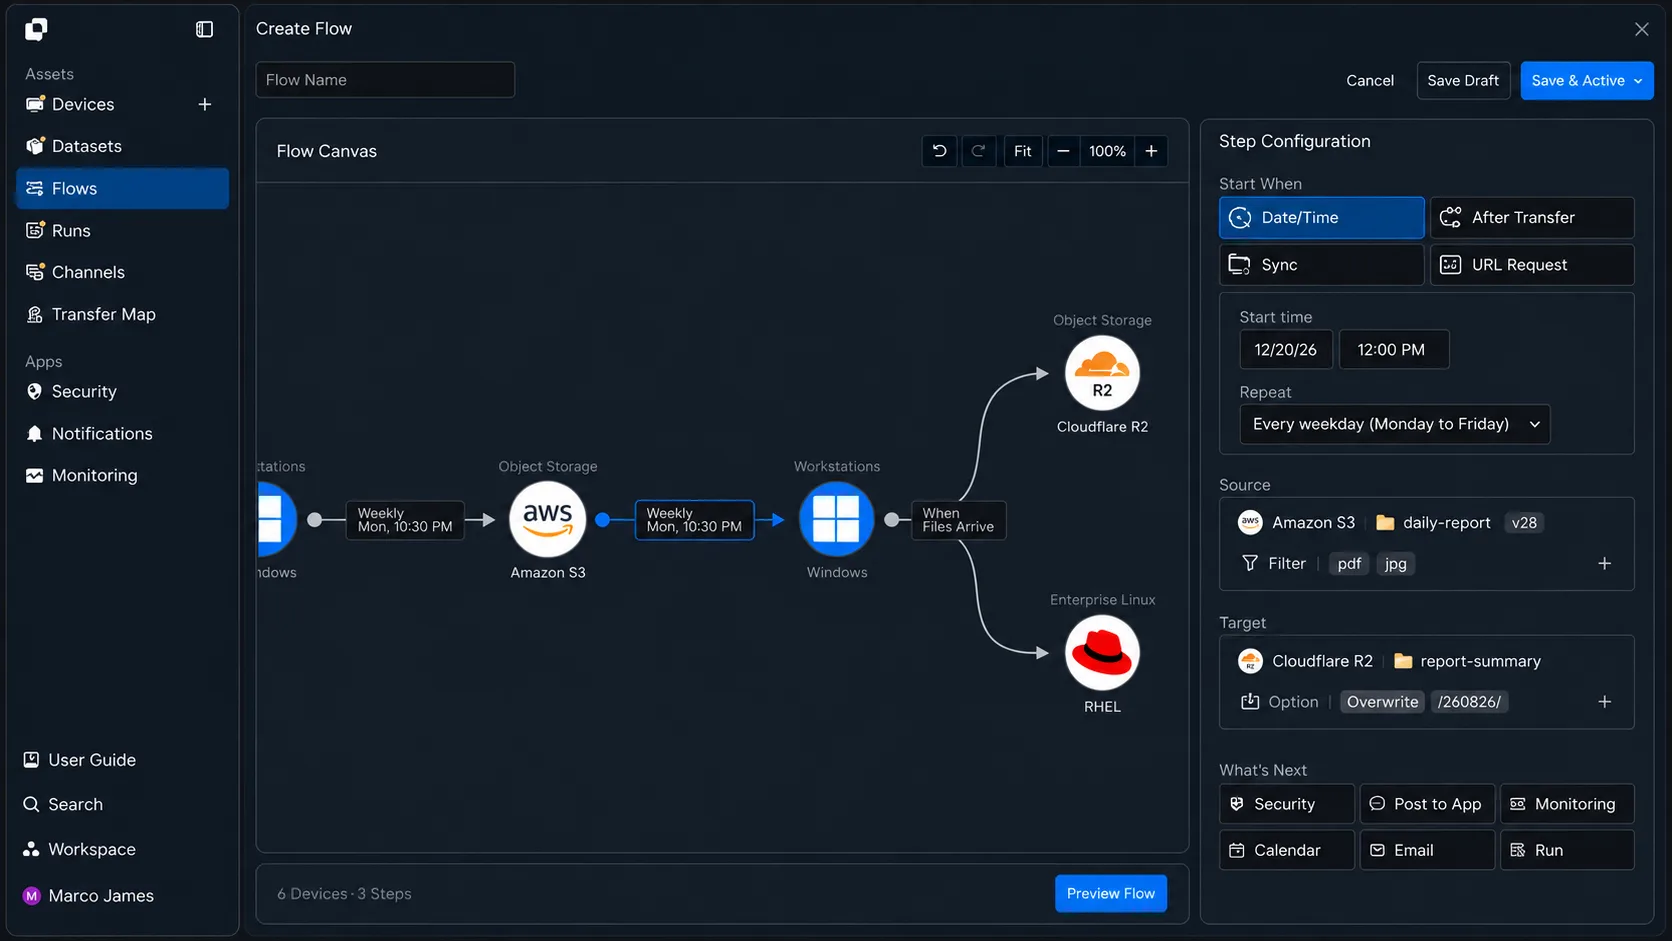
업무 환경에 따라 여러 S3 경로를 하나의 R2 Bucket으로 통합하거나, 데이터 유형에 따라 서로 다른 R2 Bucket으로 분리할 수도 있습니다.
예를 들어 다음과 같이 구성할 수 있습니다.
                    ┌──▶ R2 / media/
                    │
S3 Source ── Flow ──┼──▶ R2 / backup/
                    │
                    └──▶ R2 / archive/
이렇게 하면 단순한 Storage 이전이 아니라 새로운 R2 환경의 데이터 구조에 맞춰 파일 저장 위치를 재구성하는 마이그레이션 흐름으로 확장할 수 있습니다.
대량 이전#
많은 파일과 대용량 데이터를 전송 작업으로 나누어 관리하기
대량 데이터를 이전할 때는 전체 작업을 하나의 단순한 파일 복사로 보기보다 실행 단위와 처리 결과를 기준으로 관리할 수 있습니다.
예를 들어 데이터 유형이나 Source 경로를 기준으로 이전 작업을 나눌 수 있습니다.
| 이전 구간 | Source | Target |
|---|---|---|
| 미디어 파일 | S3 media/ |
R2 assets/media/ |
| 백업 파일 | S3 backup/ |
R2 backup/ |
| 장기 보관 | S3 archive/ |
R2 archive/ |
초기 이전 과정에서는 전체 파일을 처리하고, 작업이 완료된 후에는 Runs를 통해 각 실행의 파일 수와 전송 용량을 비교할 수 있습니다.
이렇게 하면 전체 이전 범위 중 어느 데이터가 완료되었는지, 어떤 구간에서 추가 확인이 필요한지를 구분해 관리할 수 있습니다.
변경 반영#
초기 이전 이후 새로 생성되거나 변경된 파일 추가하기
초기 파일 이전이 진행되는 동안에도 S3의 원본 데이터가 계속 변경될 수 있습니다.
예를 들어 새로운 파일이 추가되거나 기존 파일이 수정되는 경우, 초기 이전 결과만으로는 S3와 R2의 최종 상태가 달라질 수 있습니다.
따라서 초기 이전 이후에는 새로 생성되거나 변경된 파일을 확인해 Target에 추가 반영할 수 있습니다.
Before Migration

S3
├── file-01
├── file-02
└── file-03


During Migration

S3
├── file-01
├── file-02  ◀ Changed
├── file-03
└── file-04  ◀ New


Final Sync

Changed / New Files
        │
        ▼
Cloudflare R2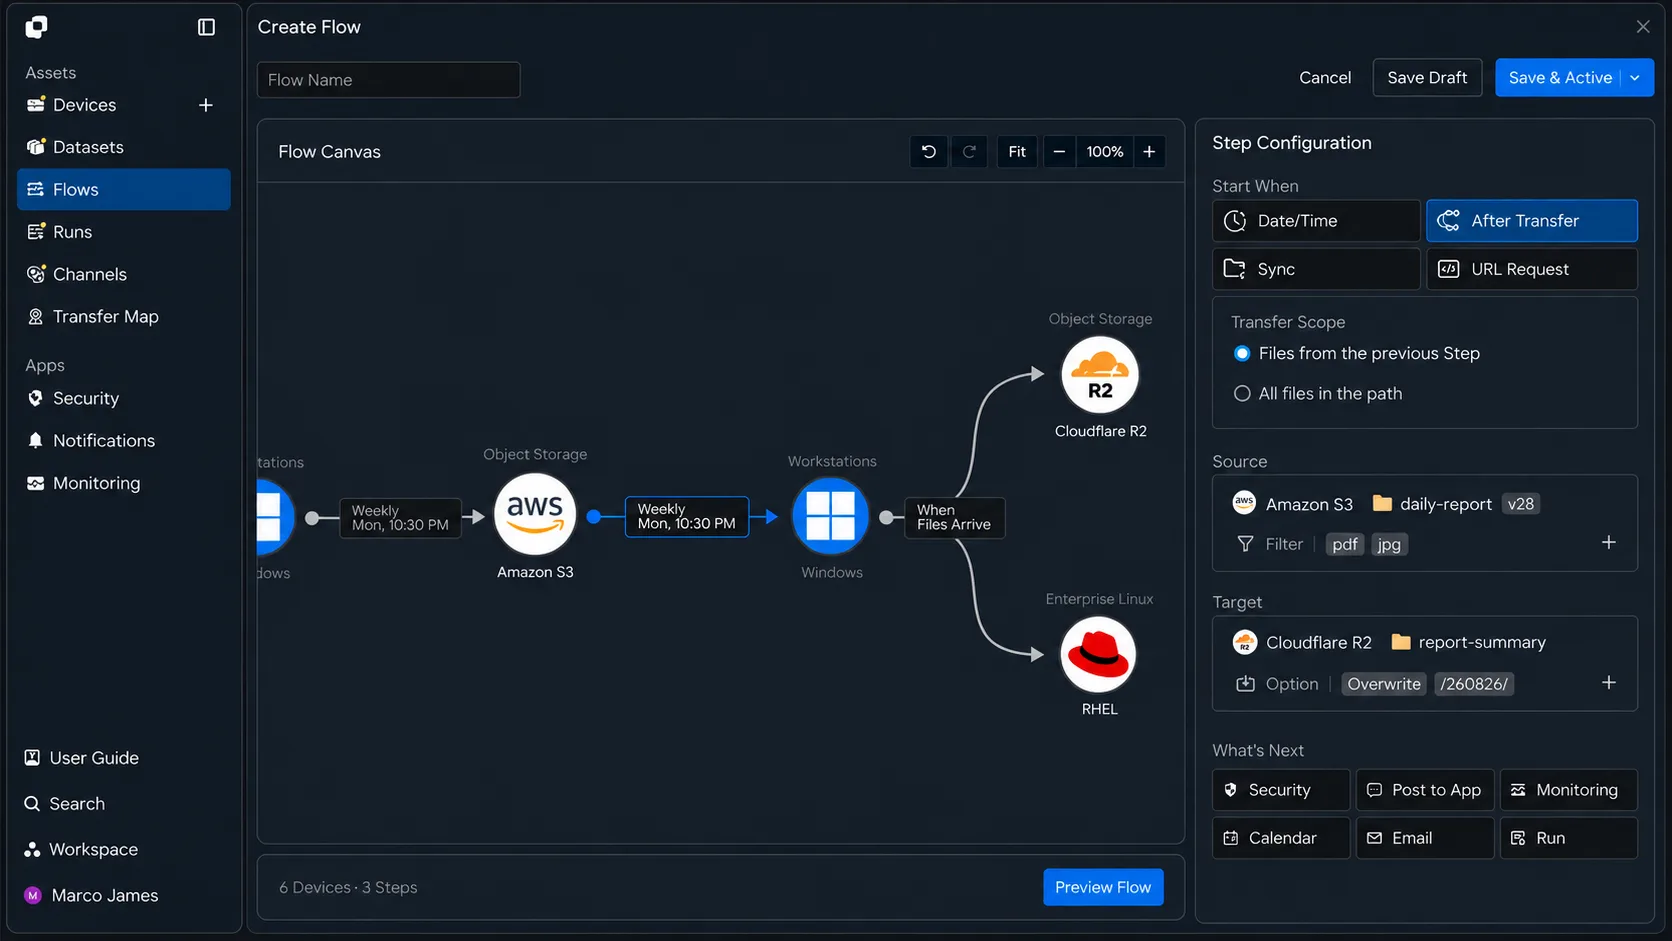
이렇게 하면 모든 데이터를 다시 전송하는 대신 초기 이전 이후 달라진 파일을 중심으로 마지막 동기화 작업을 구성할 수 있습니다.
최종 전환 전에는 마지막 변경 파일 반영 결과를 확인해 Source와 Target의 데이터 상태를 비교할 수 있습니다.
결과 검증#
파일 수와 전체 크기를 비교하고 필요한 경우 무결성까지 확인하기
파일 이전이 완료된 후에는 단순히 Run의 상태가 완료되었는지만 확인하는 것이 아니라, 실제 이전 결과를 기준으로 Source와 Target의 상태를 확인할 수 있습니다.
먼저 전체 파일 수와 전송된 데이터 크기를 비교합니다.
Migration Result

Amazon S3                    Cloudflare R2

Files: 125,430        ───▶    Files: 125,430

Size: 18.6 TB         ───▶    Size: 18.6 TB
파일 수와 전체 용량이 예상한 결과와 다르다면 누락되었거나 추가 확인이 필요한 파일이 있는지 확인할 수 있습니다.

필요한 경우 파일의 해시값이나 체크섬을 비교해 원본과 대상 파일의 무결성도 확인할 수 있습니다.
| 검증 항목 | 확인 내용 |
|---|---|
| 파일 수 | Source와 Target의 전체 파일 개수 |
| 전체 크기 | 이전된 데이터의 총 용량 |
| 파일 목록 | 누락 또는 추가된 파일 여부 |
| 전송 결과 | 성공·실패 파일과 처리 상태 |
| 무결성 | 원본과 대상 파일의 체크섬 비교 |
예를 들어 파일 수는 같지만 특정 파일의 크기나 처리 결과에 차이가 있는 경우, 해당 파일을 다시 확인하거나 필요한 파일만 재전송할 수 있습니다.
이를 통해 파일이 이동했다는 사실뿐 아니라 이전 결과가 원본 데이터와 일치하는지까지 단계적으로 확인할 수 있습니다.
전환 관리#
최종 변경 사항을 반영하고 R2 기준의 파일 운영으로 전환하기
초기 이전과 변경 파일 반영, 결과 검증이 완료되면 실제 업무에서 사용할 Storage를 S3에서 R2로 전환할 수 있습니다.
전환 전에는 다음과 같은 항목을 마지막으로 확인할 수 있습니다.
Migration Status

Initial Files       ✓ Completed
Changed Files       ✓ Synced
File Count          ✓ Verified
Total Size          ✓ Verified
Integrity Check     ✓ Verified
Target Storage      ✓ Ready
전환 흐름은 다음과 같이 이어집니다.
Amazon S3
    │
    │ Initial Migration
    ▼
Cloudflare R2
    │
    │ Changed File Sync
    ▼
Final Verification
    │
    ▼
Storage Cutover
    │
    ▼
R2-Based Operation
전환 이후에도 이전 작업의 실행 기록을 확인하면 어떤 파일이 언제 이동했는지와 최종 반영 결과를 함께 관리할 수 있습니다.
예외 대응#
이전 과정에서 확인이 필요한 파일만 구분해 다시 처리하기
대량 이전 과정에서 일부 파일의 처리 상태를 추가로 확인해야 하는 경우에는 전체 이전 작업을 처음부터 다시 실행할 필요 없이 Run의 상세 정보를 통해 문제가 발생한 구간을 확인할 수 있습니다.
문제가 발생한 위치에 따라 Source와 Target을 구분해 확인합니다.
Migration Run
       │
       ▼
  View Details
       │
       ▼
┌──────┴──────┐
│             │
▼             ▼
S3 Source     R2 Target
│             │
│             │
Path          Bucket
Permission    Target Path
File Status   Write Access
│             │
└──────┬──────┘
       ▼
   Environment Fix
       │
       ▼
      Retry
       │
       ▼
 Verification
예를 들어 S3의 특정 파일을 읽을 수 없는 경우에는 Source 경로와 접근 범위를 확인하고, R2에 저장되지 않은 파일이 있는 경우에는 Target Bucket과 저장 경로를 확인할 수 있습니다.
환경을 조정한 뒤에는 필요한 작업을 다시 실행하고, 새로운 Run에서 파일 수와 처리 결과를 다시 확인합니다.
이 가이드를 적용하면 Amazon S3 연결 → 이전 범위 선택 → Cloudflare R2 Target 구성 → 초기 대량 이전 → 변경 파일 추가 반영 → 파일 수와 전체 크기 비교 → 무결성 검증 → 최종 전환 → 실행 결과 관리까지 하나의 마이그레이션 흐름으로 구성할 수 있습니다.
이를 통해 로컬 PC나 중간 저장 서버를 거치지 않고 S3의 데이터를 Cloudflare R2로 직접 이전하고, 초기 데이터 이동부터 변경 파일 동기화와 최종 검증, Storage 전환까지 이어지는 대용량 오브젝트 스토리지 마이그레이션 환경을 구성할 수 있습니다.
개발자#
S3 객체를 R2로 이전하고 규모·실패를 확인하기
소스·대상 스토리지를 각각 장비로 등록한 뒤, 프리픽스를 지정해 전송을 만들고 종료 상태와 파일 목록을 확인합니다. 시작 전에 다음 항목을 준비합니다.
| 준비물 | 내용 |
|---|---|
| INNORIX 인증 | INNORIX_ACCESS_TOKEN (Authorization: Bearer) |
| 소스 S3 장비 | S3 버킷의 device ID와 원본 프리픽스 (예: assets/2026) |
| 대상 R2 장비 | R2 버킷의 device ID와 대상 프리픽스 (예: assets/2026) |
| 런타임 | Python 3 + requests · Java 17+ · Node.js 18+ · .NET 8+ |
Python·Node.js는 REST를 직접 호출하는 최소
api()헬퍼와 상태 상수(STATUS_COMPLETE·TERMINAL)를 API 호출 레시피의 것을 재사용합니다. Java·C#은 번들 소스의InnorixClient(상수 포함)와Json(C#은J) 헬퍼를 사용합니다. 장비 식별자(s3-src·r2-dst)와 프리픽스는 실제 값으로 바꿔 넣습니다.
S3 → R2 이전 생성#
프리픽스를 폴더 루트로 넣어(sourcePaths + sendAllFolder) 전송을 만듭니다. target-action은 overwrite로 지정해 대상 프리픽스에 같은 대상 키의 객체가 있을 때 덮어쓰도록 합니다. 전송 생성 후 monitorId로 종료 상태를 확인합니다.
import time


def transfer_objects(source, target, prefixes, target_prefix, action="overwrite"):
    transfer = api("POST", "/api/transfers/manual", {
        "sourceDevice": source,
        "targetDevice": target,
        "targetPath": target_prefix,
        "sourcePaths": prefixes,
        "sendAllFolder": True,
        "transferOptions": {"target-action": action},
    })
    return transfer["monitorId"]


def wait_transfer(monitor_id, timeout=14400, interval=5):
    deadline = time.time() + timeout
    while time.time() < deadline:
        detail = api("GET", f"/api/transfers/{monitor_id}") or {}
        if detail.get("status") in TERMINAL:
            return detail
        time.sleep(interval)
    raise TimeoutError(monitor_id)


monitor_id = transfer_objects("s3-src", "r2-dst", ["assets/2026"], "assets/2026")
detail = wait_transfer(monitor_id)
print("completed:", detail.get("status") == STATUS_COMPLETE)
static String transferObjects(InnorixClient client, String source, String target,
List<String> prefixes, String targetPrefix, String action) {
Map<String, Object> transfer = client.apiObj("POST", "/api/transfers/manual", Json.newObj(
"sourceDevice", source,
"targetDevice", target,
"targetPath", targetPrefix,
"sourcePaths", prefixes,
"sendAllFolder", true,
"transferOptions", Json.newObj("target-action", action)), null);
return Json.str(transfer, "monitorId");
}
static Map<String, Object> waitTransfer(InnorixClient client, String monitorId,
long timeoutSec, long intervalSec) throws InterruptedException {
long deadline = System.currentTimeMillis() + timeoutSec * 1000;
while (System.currentTimeMillis() < deadline) {
Map<String, Object> detail = client.apiObj("GET", "/api/transfers/" + monitorId, null, null);
Integer status = Json.intOrNull(detail, "status");
if (status != null && InnorixClient.TERMINAL.contains(status))
return detail;
Thread.sleep(intervalSec * 1000);
}
throw new RuntimeException("timeout: " + monitorId);
}async function transferObjects(source, target, prefixes, targetPrefix, action = "overwrite") {
const transfer = await api("POST", "/api/transfers/manual", {
sourceDevice: source,
targetDevice: target,
targetPath: targetPrefix,
sourcePaths: prefixes,
sendAllFolder: true,
transferOptions: { "target-action": action },
});
return transfer.monitorId;
}
async function waitTransfer(monitorId, { timeout = 14400, interval = 5 } = {}) {
const deadline = Date.now() + timeout * 1000;
while (Date.now() < deadline) {
const detail = (await api("GET", `/api/transfers/${monitorId}`)) || {};
if (TERMINAL.has(detail.status)) return detail;
await new Promise((r) => setTimeout(r, interval * 1000));
}
throw new Error(`timeout: ${monitorId}`);
}
const monitorId = await transferObjects("s3-src", "r2-dst", ["assets/2026"], "assets/2026");
const detail = await waitTransfer(monitorId);
console.log("completed:", detail.status === STATUS_COMPLETE);static async Task<string> TransferObjectsAsync(InnorixClient client, string source, string target,
IEnumerable<string> prefixes, string targetPrefix, string action = "overwrite")
{
var transfer = await client.ApiObjAsync("POST", "/api/transfers/manual", new JsonObject
{
["sourceDevice"] = source,
["targetDevice"] = target,
["targetPath"] = targetPrefix,
["sourcePaths"] = J.ArrOfStrings(prefixes),
["sendAllFolder"] = true,
["transferOptions"] = new JsonObject { ["target-action"] = action },
});
return J.Str(transfer, "monitorId");
}
static async Task<JsonObject> WaitTransferAsync(InnorixClient client, string monitorId,
int timeoutSec = 14400, int intervalSec = 5)
{
DateTime deadline = DateTime.UtcNow.AddSeconds(timeoutSec);
while (DateTime.UtcNow < deadline)
{
JsonObject detail = await client.ApiObjAsync("GET", quot;/api/transfers/{monitorId}", null, null);
int? status = J.IntOrNull(detail, "status");
if (status != null && InnorixClient.Terminal.Contains(status.Value))
return detail;
await Task.Delay(intervalSec * 1000);
}
throw new TimeoutException(monitorId);
}덮어쓰기 동작
numbering을 사용하면 대상에 같은 이름의 객체가 있을 때 이름이 변경될 수 있습니다. 이전 후 대상 키를 원본과 동일하게 유지하려면overwrite를 사용합니다.
이전 규모 확인 무결성 검증은 지원되지 않으므로, 이전 완료 후
GET /api/transfers/{id}/files로 파일 목록과 실패 객체를 확인해 이전 규모를 점검합니다.
실패 객체가 남으면 중단 후 재개 레시피의 retry_failed(GET /api/transfers/{id}/files → POST /api/transfers/{id}/retry)로 실패분만 다시 전송합니다.
구현 결과#
이 레시피를 적용하면 다음 흐름으로 S3 데이터를 R2로 이전할 수 있습니다.
Amazon S3 (s3-src) — 프리픽스 지정
   ↓
전송 생성 (overwrite) → 종료 상태까지 대기
   ↓
Cloudflare R2 (r2-dst) — 대상 프리픽스에 객체 반영
   ↓
파일 목록 확인 · 실패 객체만 재시도
스토리지 자격 증명을 코드에서 다루지 않고 device ID만으로 S3 → R2 이전을 실행하며, 파일 목록으로 규모를 확인하고 남은 실패 객체만 다시 보낼 수 있습니다.